セキュリティAIにおけるハルシネーションの定義と誤判断の構造
チャットボットが存在しない論文をもっともらしく生成する現象は、すでに広く知られています。セキュリティAIでも同じことが起こります。現象を要約したデータだけで判断せざるを得ない状況では、AIは事実と異なる結論を確信をもって提示します。原理は同じですが、結果の重みが異なります。一般領域のハルシネーションは誤った回答で終わります。セキュリティ領域のハルシネーションは、正常な通信を脅威と判定する誤検知(False Positive)や、実際の脅威を正常として通してしまう検知漏れ(False Negative)となり、そのまま対応の失敗につながります。
原因は判断根拠の空白です。ログとアラートは何が起きたのかを記録するだけで、それがなぜ起きたのか、実際の通信内容が何だったのかまでは含みません。AIはこの空白を推定で埋めます。推定はもっともらしいほど、かえって危険です。結果の情報だけでは、根拠のある判断と区別がつかないためです。
ハルシネーションが残す運用コスト:悪循環と両極端
ハルシネーションのコストは、誤った判断が1件発生するだけでは終わりません。誤検知が積み重なると、アナリストは発生したアラートを1件ずつ手作業で確認しなければなりません。検証の負担が増えるほどアラート全体への注意力は低下し、その間に実際の脅威を見逃しやすくなります。誤検知がさらなる誤検知を招く悪循環です。
判断の根拠が確認できない場合、運用担当者の行動は両極端に分かれます。AIのアラートをそのまま受け入れて誤った遮断や隔離を実行するか、信頼できないと判断してアラート全体を無視するかです。どちらの場合も、AIを導入した意味は失われます。前者は誤判断を自動で実行する構造であり、後者はアラートの生成だけにコストを費やす構造です。
規制産業では、このコストが運用の範囲を超えて制度面にまで広がります。金融、医療、公共の環境において、根拠を示せないAIの判断は監査対応の失敗や法的責任につながりかねません。また、誤判断に基づく措置や報告は、それ自体が責任問題となります。
制度が求める内容は、管轄が異なっても共通しています。韓国では「個人情報の安全性確保措置基準」により、個人情報処理システムのアクセス記録を1年以上保管することが求められ、情報主体が5万人以上の場合や、固有識別情報と機微情報を扱う場合は2年以上の保管が必要です。日本の個人情報保護法では、個人データの漏えいが発生した場合、個人情報保護委員会に対して速報を3日から5日以内に、確報を30日以内に提出することが求められています。米国のNYDFS 23 NYCRR Part 500はインシデントの検知と対応に用いる監査証跡(Audit Trail)を3年以上保存することを求め、EUのデジタル・オペレーショナル・レジリエンス法(DORA)は、2025年1月17日の適用開始以降、セキュリティアーキテクチャが規制要件を満たしているかを自ら点検することを求めています。判断の精度だけでなく、判断の根拠を示せるかどうかが導入要件となっている背景は、ここにあります。
セキュリティAIにおけるRAG:ハルシネーションを構造で減らす入力設計
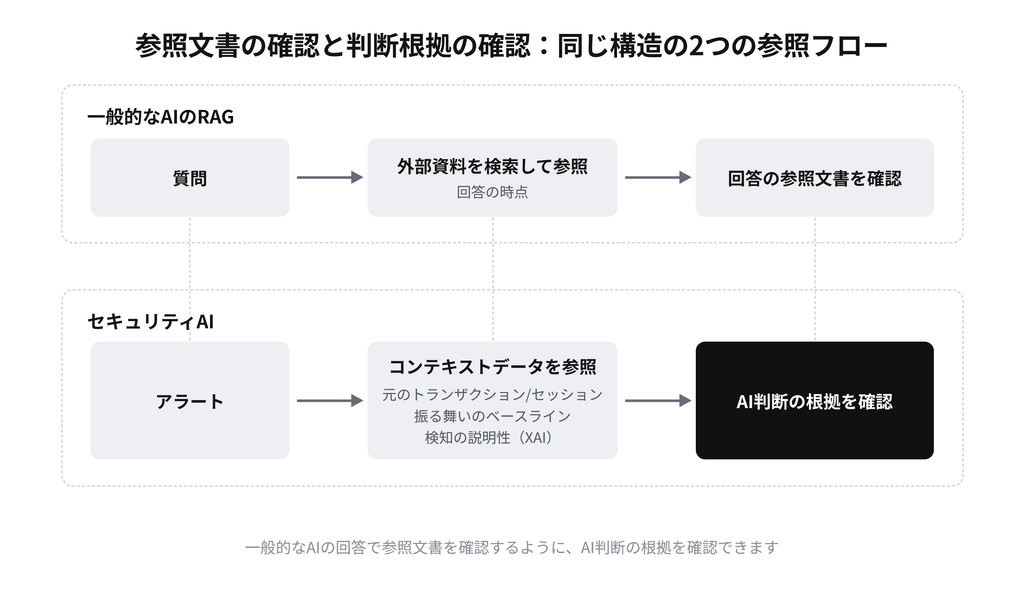
一般的なAIの領域でハルシネーションを減らす代表的な方法が、検索拡張生成(RAG)です。モデルが学習した記憶だけで回答させるのではなく、回答の時点で外部資料を検索して参照させる構造です。ハルシネーションをモデルの入れ替えではなく参照構造の設計によって減らすという点で、アプローチが異なります。
セキュリティAIにおいて、この参照構造にあたるものがコンテキストデータです。AIにアラートの要約だけを見て判断させるのではなく、判断の時点で元のトランザクション/セッションから実際の通信内容を確認させ、振る舞いのベースラインによって平常時からの逸脱の度合いを参照させます。さらに検知の説明性(XAI)が、どのような根拠でその判断に至ったのかを経路として残せば、運用担当者は一般的なAIの回答で参照文書を確認するのと同じように、AIの判断根拠を確認できます。
ただし、3つの層を保存しておくだけでは十分ではありません。AIが判断する時点で、そのデータを呼び出して利用できる必要があります。保管要件を満たした構造であっても、判断の時点で元のデータに到達できなければ、AIは再び要約だけを見て判断することになります。
層の結合と誤検知の判別方法
参照構造の効果は各層で現れ、層が結合したときにさらに大きくなります。振る舞いのベースラインが平常時と異なるセッションを検知したら、そのセッションの元のデータをフルパケットから復元し、実際の内容を確認します。この結合があれば、逸脱したセッションが実際の脅威なのか、通常業務のパターンが一時的に変化したものなのかを、推定ではなく確認によって判別できます。
実際の脅威と確認された場合にも、同じ結合が調査の段階で再び使われます。元のデータが残っていれば、侵入経路、実行の過程、外部との通信、情報漏えいの有無までを1つのインシデントの流れとして再構成できます。調査は、ログの間を行き来する循環的な確認ではなく、元のデータに基づく確認作業になります。判断の過程が検知の説明性として残るため、事後検証や監査対応にも同じ根拠を活用できます。
環境条件:閉域網とクラウド
参照構造は、データがどこにあるかによって設計が変わります。閉域網の環境では、元のデータが外部に送信されない構造がむしろ有利に働きます。AIが内部に保存された元のデータだけを参照して判断すれば、外部データへの依存から生じる汚染の可能性と、機微なデータの漏えいリスクがともに小さくなります。ハルシネーションの抑制とデータ保護が同じ構造で実現されます。
クラウド環境では逆に、元のデータを取得できるかどうか自体が検討事項になります。仮想ネットワークのトラフィックミラーリングは、サービスごとに対応範囲と処理容量に制約があるため、オンプレミスと同水準の全量収集が可能かどうかから確認する必要があります。ミラーリング区間で損失が生じれば、その区間はAIが参照できない領域となり、参照できない領域での判断は再び推定に依存することになります。
PoCでハルシネーションの可能性を検証する問い
導入検討の段階では、ハルシネーションの可能性を機能一覧ではなく実演で確認します。次の3点を依頼すれば、参照構造を確認できます。
- 同じアラートの根拠を示せるか:発生したアラートを1件選び、AIがどの特徴とデータに基づいて判断したのかをその場で提示するよう依頼します。根拠を示せなければ、運用段階で両極端な行動が繰り返されます。
- 逸脱したセッションの元のデータを復元できるか:振る舞いのベースラインが検知したセッションを元のデータのレベルまで復元し、誤検知かどうかを判別する過程を実演するよう依頼します。復元できなければ、誤検知の判別は依然として手作業の推定にとどまります。
- 参照できない区間はどこか:収集方式と環境の制約によってAIが参照できない区間を明示するよう依頼します。明示されない空白は、運用中に推定で埋められます。
3つの問いに共通するのは、モデルの性能を問うていない点です。ハルシネーションは、モデルの入れ替えではなく、判断の時点で参照するデータを変えることによって減らせます。導入検討の焦点も、参照構造の完全性に合わせるべきです。この完全性が確保されたとき、検知から分析、判断、対応へとつながる自律型セキュリティ運用(Autonomous Security Operations)も、信頼できる根拠の上で機能します。
よくあるご質問
Q. セキュリティAIのハルシネーションは、一般的なAIのハルシネーションと何が違うのですか。
原理は同じです。参照できる根拠がない状態で判断すれば、もっともらしい誤った回答が出ます。セキュリティ領域では、その誤った回答が誤った遮断や脅威の放置といった実際の対応につながり、規制環境では監査や責任の問題にまで広がるという点で、結果の重みが異なります。
Q. 検知の説明性(XAI)のないセキュリティAIは、実際に問題になりますか。
判断の根拠が確認できなければ、運用担当者はアラートをそのまま受け入れるか、全体を無視するかの両極端に分かれ、どちらの場合も誤検知が積み重なり、対応の品質が低下します。判断の過程を確認できてはじめて、アラートを受け入れるか棄却するかを根拠に基づいて判別できます。
Q. 導入前にハルシネーションの可能性をどのように検証すればよいですか。
PoCの段階で、アラートの判断根拠の提示、逸脱したセッションの元のデータの復元、参照できない区間の明示を、実演として直接依頼することが最も実質的です。機能一覧やカバレッジの数値だけでは、判断の時点における参照構造を確認することは困難です。