攻撃の自動化と防御条件の変化
2026年4月に公開された汎用AIモデル「Claude Mythos(クロード・ミトス)」は、OpenBSDで27年間、FFmpegで16年間発見されていなかった脆弱性を、人の介入なしに検知しました。Linuxでは、コードの欠陥を連鎖的に組み合わせてサーバーを掌握する経路も自ら構成しています。このような攻撃能力は、セキュリティ専用の訓練を経ることなく、コードと推論、自律性が全般的に向上する過程で現れたものです(Anthropic 2026 に基づく)。脆弱性の発見から攻撃コードの生成までに要する時間が急速に短縮され、防御側の対応時間も減っています。この変化は、次の数値から確認できます。
脆弱性のパッチが公開された時点と、実際に悪用された時点の差(Time-to-Exploit, TTE)は、2018年には平均63日でしたが、2025年には-7日と集計されました。パッチが公開される1週間前には、すでに悪用が始まっているという意味です。最初の侵入から後続の攻撃が始まるまでの時間も、2022年の8時間以上から2025年には22秒へと短縮されています(Mandiant M-Trends 2026 に基づく)。人がアラートを確認して対応を判断するサイクルでは追いつけない速度です。
攻撃が自動化されると、侵入から目的の達成までの段階が短くなり、亜種も急速に増えます。あらかじめ定義した検知ルールとシナリオに依存する方式では、定義されていない攻撃を検知することが困難です。防御側にも、状況を自ら解釈して次の行動を決めるエージェンティックAIが必要になった背景は、ここにあります。
ここで確認しておくべき点があります。攻撃と防御の自動化は対称ではありません。攻撃側のAIは数千回試して一度成功すれば済みますが、防御側のAIは一度の誤った判断も実際の運用に影響を及ぼしかねません。誤検知で正常なサービスを隔離すれば業務が停止し、脅威を検知できなければ侵害が進行します。失敗のコストが低い攻撃の自動化とは異なり、防御の自動化では判断の一つひとつに根拠が必要です。したがって、防御データに求められる条件はより厳格でなければなりません。
この要求をデータの観点から整理すると、次のようになります。入力データの品質は、モデルの性能と同じく判断の精度を左右します。現象を要約したログやアラートは、発生した状態を示すだけで、原因を判断するための元のデータを提供しません。根拠のないまま速度だけを高めた判断は、防御ではなく新たなリスクです。
ログとアラートに依存する構造がAIの判断に残す4つの空白
状態情報とは、検知イベント、システムログ、アラートのように、現在の状況を要約したデータです。ただし、根本原因を追跡するために必要な元のデータは含みません。問題は、セキュリティ運用の大半がこの状態情報に依存している点にあります。この構造では、エージェンティックAIを導入しても十分な判断根拠を確保することが難しく、その結果、AIの判断精度と信頼性を低下させる4つの空白が生じます。
- 根本原因分析の空白:イベントログは、発生した状態を示すだけです。攻撃がどの経路で入り、何を経てどこまで到達したのかを追跡するには、元のパケットとセッションが必要です。ログだけで調査すると、あるシステムのログから別のシステムのログへ移り歩きながら同じ現象を再確認する循環的な調査が繰り返され、その間に攻撃者は次の段階へ移動します。
- 事前定義の空白:すべての脅威の類型をあらかじめ定義し、対応ルールを作成しておくことは困難です。攻撃者が検知ルールを回避したり、正規のツールを悪用したりすれば、ルールは機能しません。亜種が自動的に生成される環境では、定義されていない領域は縮小するどころか、むしろ拡大します。
- アラート処理の空白:状態情報に基づく検知は、誤検知が増える構造です。処理すべきアラートが増えるほど、実際の脅威が大量のアラートに埋もれるリスクも大きくなり、アラートの信頼度が下がれば、自動化された措置に対する信頼も同時に低下します。
- データ連携の空白:複数のシステムに散在するログを1つの攻撃の流れとして再構成する作業は、時間もコストも大きくなります。AIは、組織全体のデータをつないで分析できるときに性能を発揮します。サイロに分断された不完全なデータで学習し判断するAIは、誤った結論に至ります。
4つの空白は、人が運用する場合には調査の遅延として表れます。判断を自律に委ねると、性格が変わります。誤った判断がレビューを経ないまま次の行動へつながるリスクになるのです。エージェンティックAIを導入する際には、データ品質の要件が従来の運用よりはるかに高くなります。
判断構造の比較:状態情報ベースのAIとコンテキストデータベースのAI
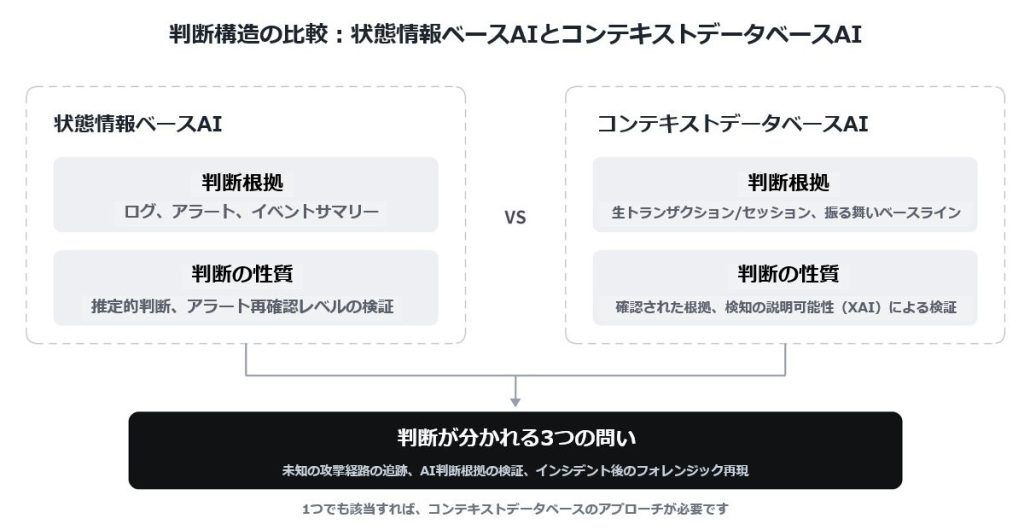
2つのアプローチの違いは、どのデータで判断するのかから始まり、可視性の範囲、誤検知の発生構造、事後検証の可能性にまで及びます。
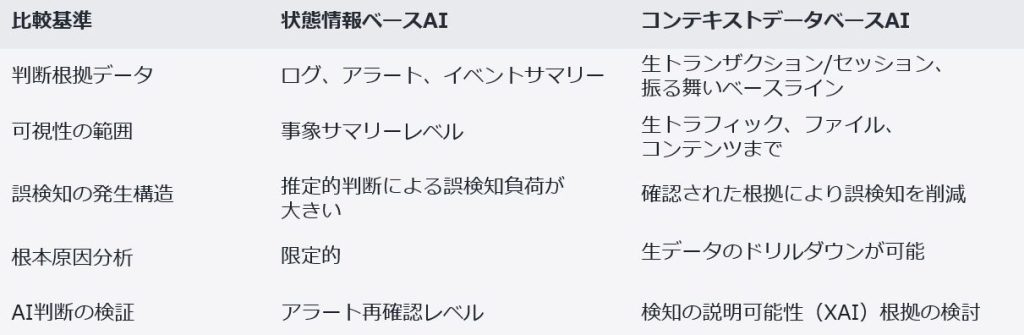
5つの基準は、互いに密接につながっています。判断根拠が要約された情報にとどまれば可視性も限定され、不完全な情報に依存した推定が増えて誤検知の可能性が大きくなります。また、元のデータがなければ、根本原因を追跡したり、AIの判断過程を検証したりすることが困難です。結局、どのデータを判断根拠として使うのかが、残る4つの基準の水準を左右します。
状態情報ベースのアプローチにも、明確な使いどころがあります。すでに知られた脅威の類型を素早く処理したり、大規模なイベントをフィルタリングしたりするように、シナリオが明確な環境ではこの方式が効率的です。コンテキストデータベースのアプローチが必要かどうかは、判断品質を左右する3つの課題で確認します。未知の攻撃経路の追跡、AIの判断根拠に対する運用担当者の検証、インシデント後の完全なフォレンジック再現の必要性です。1つでも該当すれば、コンテキストデータベースのアプローチへ移行する必要があります。
移行を検討する際は、コストの構造もあわせて確認する必要があります。状態情報ベースの構造は初期構築コストが低い一方で、誤検知の検証と循環的な調査にかかる運用コストが、アラート量に比例して増えていきます。コンテキストデータベースの構造は、元のデータの収集と保存に初期投資が必要です。その代わり、判断根拠がデータの中に含まれているため、繰り返しの検証コストが小さくなります。エージェンティックAIの導入は、判断の回数を大きく増やす決定です。判断1件あたりの検証コストが低い構造を先に備えるほうが、総コストの面で有利です。
第一の条件、元のデータ:AIの判断範囲を決める層
コンテキストデータの出発点は、元のデータです。サンプリングでは収集対象から漏れるパケットが生じ、メタデータの収集では通信の実際の内容までは復元できません。フルパケット収集によって収集区間のトラフィックを全量保存する構造がなければ、エージェンティックAIの運用において3つのリスクが実際に表れます。
- 判断できない領域の発生:収集されなかった区間は、AIが判断できない領域として残ります。AIが扱える範囲の上限を決めるのは、モデルの性能ではなく収集範囲です。
- 過去のトラフィックを調査できない:元のトラフィックデータがなければ、新たな脅威指標を発見しても、過去に同じ脅威が流入していたかどうかを確認できません。攻撃が自動化された環境では、検知よりも侵入が先行するケースが増えます。過去のデータを再分析できてはじめて、新たな脅威にも対応できます。
- 判断への信頼の低下:不完全なデータで判断すれば誤検知が増え、誤検知が繰り返されると、運用担当者は自動化された判断をそのまま受け入れなくなります。その結果、自動化によって得た効率が、検証の負担で相殺されます。
ソフトウェアサプライチェーン攻撃が代表的な例です。悪意ある行為が正常な通信チャネルに乗って行われるため、コード署名やパッケージの完全性検査だけでは防ぐことが難しく、元のトラフィックを直接分析しなければ検知自体が困難です。このような攻撃類型では、元のデータを全量収集しておいてはじめて、判断の根拠が残ります。
第二・第三の条件:ベースラインと説明性
元のデータは、正確な判断の出発点です。ここに、一貫した分析の基準と、判断結果を検証できる仕組みが加わる必要があります。
振る舞いのベースライン(Behavioral Baseline)データは、正常なパターンから逸脱した活動を識別し、元のトランザクション/セッションデータは、その活動の詳細な内容とコンテキストを提供することで、実際に脅威かどうかを判断できるようにします。振る舞いのベースラインデータがなければ、AIは個々のイベントを独立したシグナルとしてのみ処理します。その結果、正常な活動を装った内部者の脅威や、長期間にわたって密かに進行する攻撃を検知することが難しくなります。逸脱の方向と大きさが数値として入力されれば、AIは異常かどうかを分ける二値の判断を超えて、コンテキストを踏まえた判断を下せます。
検知の説明性(XAI)は、AIがどのデータと特徴に基づいて判断したのかを運用担当者が検討できるよう、判断の過程を残す層です。自律的な判断の範囲が広がるほど、この層の重要性も高まります。2つの層がない環境で、エージェンティックAIが直面する判断の誤りは、3つの類型として表れます。
- 誤検知の増加:正常と異常を分けるベースラインがなければ、AIは閾値ルールに依存することになり、誤検知の負担が大きくなります。
- 判断根拠の不透明さ:AIがどの特徴に基づいて脅威と判定したのかが分からなければ、運用担当者はその判断を受け入れるかどうかを自ら見極められません。
- 検証コストの増加:判断の過程を確認できないAIは、誤検知への対応の過程で繰り返しの手作業確認を必要とし、自動化の効果を相殺します。また、誤った自律的措置が発生したときの責任の所在も不明確になります。
説明性は、AIの判断を無条件に信頼させるための仕組みではありません。特徴量の寄与度と判断の過程が見えれば、運用担当者はAIの判断の信頼性を自ら検討し、誤検知を素早く見極められます。この検証可能性が、自律実行の範囲を広げる際の判断根拠になります。
産業別のデータ要件:規制と環境構造による違い
同じデータ基盤であっても、産業の環境によって求められる水準は変わります。共通点は1つです。どの環境であれ、エージェンティックAIが判断するには、判断の根拠となる元のデータを、その環境の制約の中で確保する必要があります。
- 金融:元のトラフィックの保存、内部者の異常な振る舞いの検知、規制順守の証跡の確保が同時に求められます。管轄ごとに規制の名称は異なっても、求められることは共通しています。韓国では「個人情報の安全性確保措置基準」が、個人情報処理システムのアクセス記録を1年以上、情報主体が5万人以上の場合や固有識別情報・機微情報を取り扱う場合は2年以上保管するよう求めています。日本では金融分野のサイバーセキュリティガイドラインが2024年10月4日に公表され、ログの記録とインシデント対応体制が求められており、個人情報保護法は漏えい等の速報を3日から5日以内に提出するよう定めています。米国のNYDFS 23 NYCRR Part 500は、インシデントの検知と対応に用いる監査証跡(Audit Trail)を3年以上保存し、インシデントを72時間以内に報告するよう求めています。EUのデジタル・オペレーショナル・レジリエンス法(DORA)は、2025年1月17日の適用開始以降、セキュリティアーキテクチャが規制要件を満たしているかを自ら点検することを求めています。AIの判断根拠となる元のデータを、規制の点検や監査に提示できるかどうかまであわせて確認する必要があります。
- 防衛:ネットワーク分離の構造では、外部インテリジェンスへの依存が制限されます。閉域網の内部で内部トラフィックを全量分析して振る舞いのベースラインを学習し、判断根拠を自前で確保する構造が必要です。
- 製造、OT:生産ラインを停止させずに産業用プロトコルを分析できる必要があります。可用性が最優先の環境では、遮断中心の対応よりも、元のデータに基づく正確な判断と影響範囲の確認が先です。
- 医療:患者データの非識別化の要件と、医療機器ネットワークの可視性の確保を同時に満たす必要があります。個人情報保護の制約の中で、元のデータのレベルで調査根拠を維持できるよう設計する必要があります。
導入の順序とデータインフラの先行条件
導入の検討は、モデルの性能比較ではなく、データインフラの確認から始まります。判断根拠となるデータなしに導入されるエージェンティックAIは、推定を自動化するにすぎず、自律実行の範囲が広いほどそのコストは大きくなります。
- 元のデータの収集と保存:フルパケットに基づく全量収集と、元のトランザクション、セッションの保存、過去のトラフィックを調査できる状態をまず確保します。判断できない領域をなくす段階です。
- ベースラインの学習:資産ごとの正常パターンを学習し、逸脱を定量化する振る舞いのベースラインを確立します。AIの判断に基準を与える段階です。
- 検証構造の確保:検知の説明性(XAI)によって判断の過程を検討できる構造を備えます。自律実行の範囲をどこまで広げるかを決める根拠を立てる段階です。
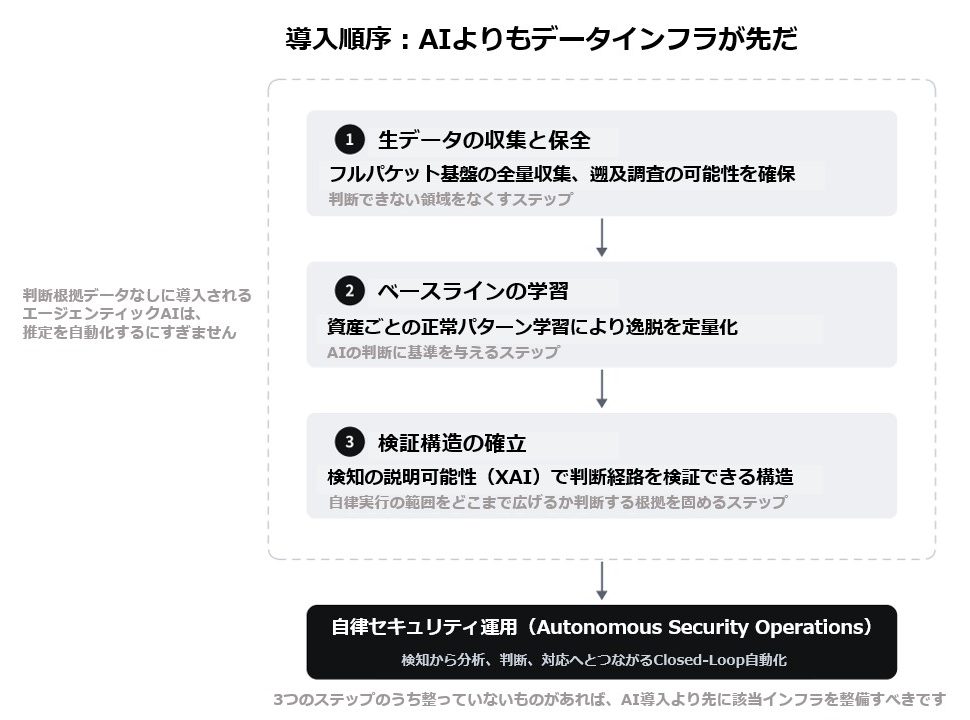
競争力は、より優れたAIを選ぶことよりも、そのAIが判断に活用するコンテキストデータを備えることに近いといえます。判断の自動化は、検知から分析、判断、対応へとつながるClosed-Loop自動化、すなわち自律型セキュリティ運用(Autonomous Security Operations)へと向かい、3つの層がそろって入力されるほど、より安定して動作します。
よくあるご質問
Q. フルパケット収集なしで、AIベースのNDR(Network Detection and Response)を導入しても効果はありますか。
メタデータに基づく分析だけでも、通信パターンや異常な振る舞いを検知できるため、一定の効果は期待できます。ただし、フルパケットデータをあわせて活用すれば、検知した振る舞いの具体的な内容とコンテキストまで分析でき、AIはより豊富な根拠に基づいて脅威を判断できます。したがって、必要な検知のレベルとデータの活用範囲に応じて、収集方式を選択する必要があります。
Q. 振る舞いのベースラインの学習には、どれくらいのデータが必要ですか。
振る舞いのベースラインデータは、資産ごとの正常パターンを十分に学習してこそ精度が高まり、学習期間と範囲は環境ごとに異なります。より重要なのは、損失のない元のトラフィックを収集できているかどうかです。サンプリングされたデータで学習すると、実際の通信の一部しか反映されず、ベースラインの精度が下がります。
Q. 既存のSIEM(Security Information and Event Management)を運用中ですが、エージェンティックAIの導入のためにNDRを追加すべきですか。
既存のSIEMは、ログとイベントに基づく可視性を提供します。元のトラフィックと振る舞いのコンテキストがなければ、エージェンティックAIの判断根拠は不完全なまま残ります。ログと元のパケット、セッションを1つの調査フローとしてつないだとき、自動化の効果が高まります。