NDRの定義と検知対象
NDRは、ネットワークトラフィックを継続的に分析して異常な振る舞いを検知し、対応するセキュリティソリューションの領域です。元のパケットとメタデータを対象に振る舞い分析を行い、外部との通信だけでなく内部システム間の通信まで監視します。
EDR(Endpoint Detection and Response)がエージェントを導入した端末内部の振る舞いを検知し、ログベースのSIEM(Security Information and Event Management)が各システムのログを収集して相関分析を行うのに対し、NDRはこの2つの層が観測できない領域を担います。エージェントを導入できない機器、正規のアカウントによって行われる内部の横方向の移動(Lateral Movement)、ログが生成されない通信がNDRの検知対象です。
NDRの導入が広がった背景には、検知ルールベースの検知の限界があります。既知の攻撃パターンと照合する方式では、正規ツールを悪用する攻撃や、初めて観測される攻撃の流れを検知できません。NDRはこの空白を振る舞い分析で補います。
振る舞い分析は、正常な振る舞いのベースラインを先に学習してはじめて異常な振る舞いを識別できます。学習されたベースラインがなければ正常範囲内の変動でもアラートが発生し、これが導入直後に誤検知が多い原因です。
カバレッジの拡大と最適化のタイムラグ
誤検知そのものは検知運用における長年の課題ですが、近年の調査では、その負担はむしろ増加していることが確認されています。2025年の調査では、回答者の73%が検知の課題として誤検知を挙げ(複数回答)、この比率は前年の64%から上昇しました(SANS 2025 Detection and Response Survey に基づく)。誤検知を頻繁に、または非常に頻繁に経験するという回答も60%を超えています(同調査に基づく)。同レポートは、検知カバレッジが拡大した速度に最適化と精度が追いついていないためと解釈しています。
NDRの導入現場でも同じ傾向が見られます。デフォルトの検知ルールを有効化し、初期の閾値をそのままにして運用を始めると、判断の根拠はアラートとログに限られます。アラートとログは発生した状態を示すだけで、ベースラインとの乖離、送信された内容、脅威と判定した根拠までは含みません。この状態で閾値だけを引き上げたり引き下げたりしても、誤検知の根本原因は解決されず、アラート件数が一時的に変動するにとどまります。
誤検知の原因となる4つの類型と類型別の対処
導入直後の誤検知は[表1]の4つの類型に分けられます。類型ごとに対処が異なるため、最適化に先立ち、運用環境で主に発生している類型を確認する必要があります。
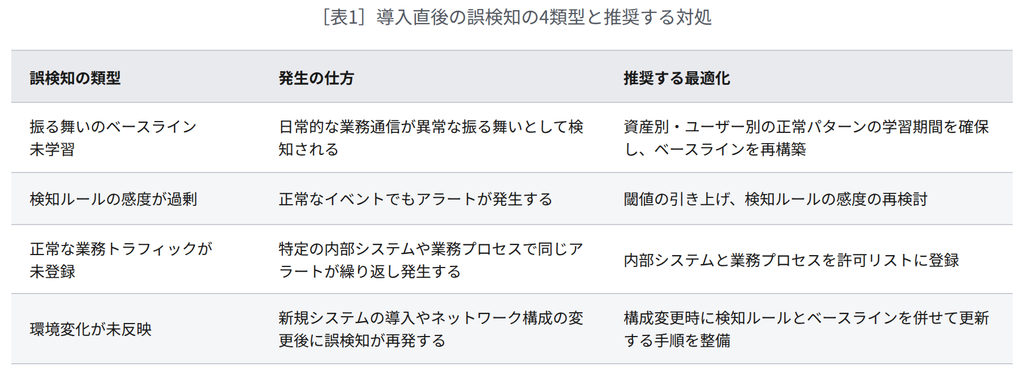
4つの類型のいずれも、アラートとログだけでは誤検知かどうかを判別できません。原因となる類型を切り分けるには、アラートとログ以外のデータが必要です。
業界動向:3つの流れの前後関係
先に引用した2025年の調査には、アラートとログ以外のデータの取得に直結する3つの流れが同時に表れています。振る舞いベースの分析ツールは、効果的47%、非常に効果的20%、効果的ではない13%と評価されました(SANS 2025 Detection and Response Survey に基づく)。検知カバレッジを点検している組織のうちMITRE ATT&CKを基準としている割合は78%で、前年の74%から上昇し、脅威検知に機械学習を活用している組織は53%でした(同調査に基づく)。振る舞い分析への移行、ATT&CKを基準としたカバレッジの点検、機械学習ベースの検知の拡大が、その3つの流れです。
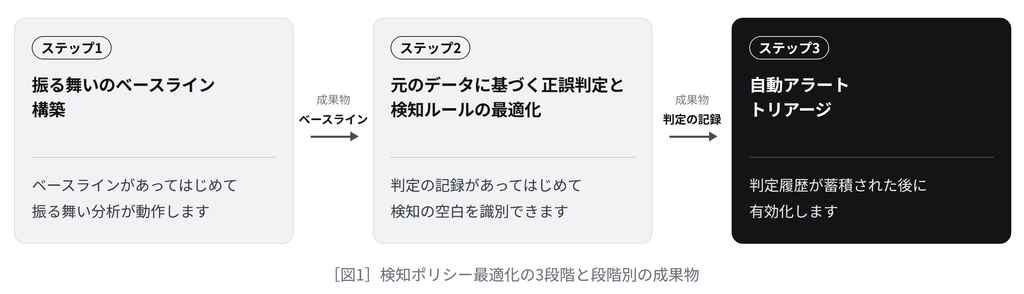
3つの流れは独立した選択肢ではなく、前後関係にあります。振る舞い分析はベースラインがあってはじめて動作し、カバレッジの点検は正誤判定の記録があってはじめて検知の空白を識別でき、機械学習ベースの検知と自動アラートトリアージは、判定履歴が蓄積されて信頼性が確保された後に有効化できます。NDR検知ポリシーの最適化は、[図1]のとおり、振る舞いのベースライン構築、元のデータに基づく正誤判定と検知ルールの最適化、自動アラートトリアージの順序で進めます。前の段階の成果物が次の段階の入力になるため、1つの段階を省略すると、次の段階では調整の根拠が不足します。
ステップ1:振る舞いのベースライン構築 ― 異常判定の基準を確保する
[図1]の最初の段階がベースラインであるのは、正常な振る舞いのパターンが学習されていない状態では、閾値を調整しても検知ルールを追加しても誤検知が減らないためです。正常な状態が定義されていなければ、異常な振る舞いも定義できません。
振る舞いのベースラインは、時間帯別の活動履歴と資産別の正常パターンを学習して構築します。振る舞い分析は、このベースラインと比較して、主要プロトコルにおける異常な通信、大容量のアップロード、セッションの急増といった兆候を検知します。学習期間は環境ごとに異なるため一律の期間は示しませんが、週単位の業務サイクルや月末の締め処理といった繰り返しのパターンが、少なくとも一度は学習範囲に含まれている必要があります。そうしてはじめて、ベースラインはそのパターンを正常として認識します。
この段階で許可リストへの登録と、構成変更時の更新手順まで整備すれば、[表1]の4類型のうち、振る舞いのベースライン未学習、正常な業務トラフィックの未登録、環境変化の未反映という3つの類型に対処できます。残る1つの類型である検知ルールの感度過剰は、元のトランザクション/セッションを確認しなければ調整できません。
ステップ2:元のデータに基づく正誤判定 ― 検知ルール最適化の根拠
検知ルールの感度調整、すなわち閾値をどの水準まで引き上げるかは、アラート件数の集計だけでは判断できません。減少したアラートが実際に誤検知だったのかを判別する必要があり、その判定にはアラート発生時点の通信の元のデータが必要です。ログとメタデータは大容量の送信があったという事実までしか記録せず、送信されたファイル、送信経路、宛先は、元のトランザクション/セッションを復元してはじめて確認できます。収集区間のトラフィックをフルパケットで保存する構成では、元のデータが正誤判定の確定的な証拠(definitive evidence)となり、同じ誤検知の再発を防ぐ根拠として活用されます。
正誤判定が蓄積されたら、検知ルールを最適化します。カバレッジ点検の基準はMITRE ATT&CKに収束しつつあり、その活用手順は次の4項目です。
- 1. カバレッジのマッピング:現在の検知ルールをATT&CKの戦術と技術にマッピングし、検知の空白を識別します。
- 2. 優先順位の設定:深刻度、業務への影響、悪用可能性を基準に、先に強化する戦術を決定します。
- 3. 振る舞いベースの検知ルールの強化:検知ルールへの依存度を下げ、振る舞いパターンを中心とした検知ルールを追加します。
- 4. 元のデータによる検証と反復:新しい検知ルールが生成したアラートを元のデータで判定し、誤検知が確認されれば検知ルールを再度調整します。
カバレッジのマッピングは検知の空白を識別するための手段であり、検知能力そのものを評価する指標ではありません。したがって、検知ルールを回避する攻撃をコンテキストに基づいて検知できるかどうかは、別途検証する必要があります。
正規ツールを悪用する攻撃(Living off the Land)は、検知ルールベースの検知の限界が最も明確に表れる領域です。OSの管理ツールを用いて行われる攻撃は、検知ルールでは正常な管理作業と区別できず、振る舞いのベースラインと比較した異常の有無と、元のセッションの内容を併せて確認してはじめて悪用かどうかを判別できます。ステップ2では、ステップ1で構築した振る舞いのベースラインに元のトランザクション/セッションが加わり、2つの層がはじめて同時に用いられます。
ステップ3:自動アラートトリアージ ― 自律範囲の段階的な拡大
正誤判定のデータが蓄積されると、アラートトリアージ(Triage)を自動化する条件が整います。優先度の低いアラートを自動的に分類し、脅威スコアを算出すれば、アナリストは高リスクのアラートに集中できます。実務上の論点は、自動トリアージを有効化するかどうかよりも、その結果をどの範囲まで信頼するかにあります。
その信頼の根拠は、検知の説明性(XAI)によって確保されます。判定に寄与した特徴量と、脅威スコア算出の経路が記録されていてはじめて、アナリストは自動トリアージの結果を検証し、誤検知を識別できます。判断の過程を確認できない自動トリアージは、誤検知が発生しても原因を修正できず、前の2段階の最適化の効果を打ち消してしまいます。
判断の過程を確認できるようになったら、対応の自動化の範囲を検討します。対応の自動化は、アラートトリアージより1段階後に位置づけます。誤検知が1件でも正常な業務を停止させうる隔離や遮断では、AIが提案し、実行の承認はアナリストが担う半自律型の構造が適しています。誤検知の可能性が極めて低く、副作用が限定的なシナリオから自律範囲を広げ、判定精度が運用データで実証された段階で、該当シナリオの自律化のレベルを引き上げます。
最適化の成果は、平均検知時間(MTTD)と平均対応時間(MTTR)、アラートに占める誤検知の割合、手動分析の比率で測定します。ただし、成果の測定自体はまだ一般化していません。MTTDを測定している組織は56%で前年の52%から増加した一方、検知と対応の指標を業界標準と定期的に比較している組織は17%で、前年の23%から減少しました(SANS 2025 Detection and Response Survey に基づく)。改善の幅は入力データと運用環境によって異なるため単一の数値は示しませんが、4つの指標は最適化の段階ごとに同じ基準で測定し、推移として比較します。
最適化の順序と3層コンテキストデータの入力順序
最適化の順序を決める条件は、攻撃の速度です。金銭目的の攻撃(eCrime)において、初期侵入から横方向の移動を開始するまでの平均時間は、2025年時点で29分です(CrowdStrike Global Threat Report 2026 に基づく)。アナリストがアラートを個別に確認する運用ではこの速度に対応することが難しく、検知から分析、判断、対応へとつながる自律型セキュリティ運用(Autonomous Security Operations)が必要になります。自律的な判断には根拠が必要であり、アラートとログだけに依存して自動トリアージを実行すれば、推定を自動化するにとどまります。
この根拠を順に確保していく過程が、検知ポリシー最適化の3段階です。ステップ1の振る舞いのベースラインが異常の有無を正常時との比較として数値で示し、ステップ2の元のトランザクション/セッションが異常なセッションの実際の内容を確定させ、ステップ3の検知の説明性(XAI)が自動トリアージの判断過程を検証します。各コンテキストデータはそれぞれの役割でトリアージの根拠を提供し、3つがそろって入力されることで、アラートトリアージ自動化の信頼性はさらに高まります。
最適化の順序を守ることは、自律的な判断に必要な入力データを順にそろえていく過程であり、その入力が完全であるほど、自律型セキュリティ運用における判定の信頼性も高まります。
最適化成熟度のセルフチェックリスト
組織の現在地は、[表2]の9項目を1つずつ充足しているかどうかで判定します。充足していない項目がある最も前の段階が、最適化に着手すべき地点です。
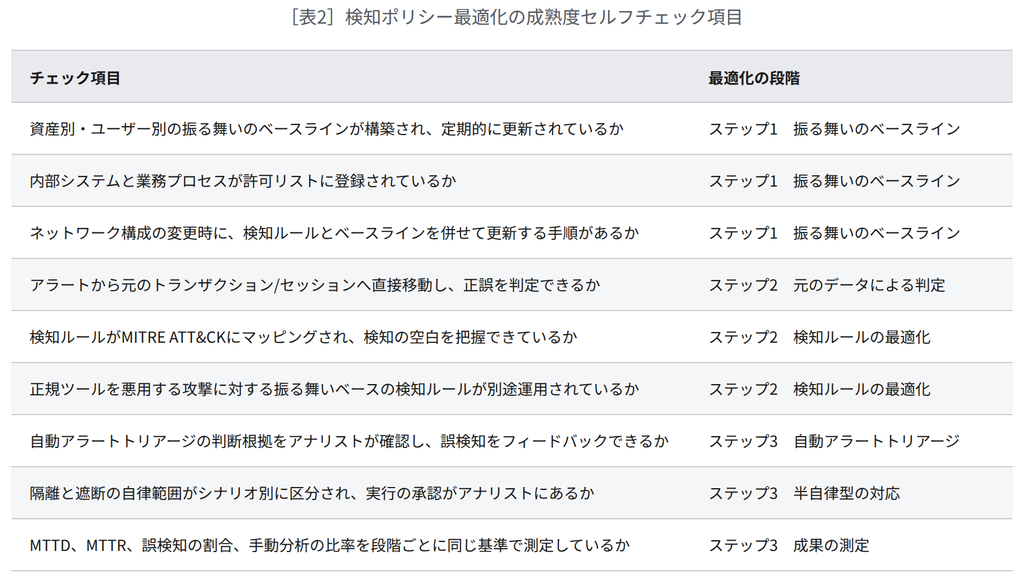
9つの項目は3段階の成果物と一致するため、充足していない項目がそのまま、次の最適化で確保すべき入力になります。
よくあるご質問
Q. アナリストのアラート疲れを減らすには、どの最適化から着手すべきですか。
自動アラートトリアージよりも、振る舞いのベースライン構築が先です。ベースラインがない状態で自動トリアージを有効化すると、誤検知がそのまま分類され、アナリストが改めて確認することになります。ベースラインと、元のデータに基づく正誤判定が蓄積された後に有効化してはじめて、優先度の低いアラートが自動トリアージによって除外されます。
Q. ネットワーク構成が頻繁に変わる環境では、ベースラインをどのように維持しますか。
構成変更の手順にベースラインの更新を含める必要があります。新規システムの導入や帯域の変更時には該当区間を再度学習し、許可リストを更新します。変更履歴を残しておけば、その後に発生した誤検知の原因がベースラインにあるのか検知ルールにあるのかを切り分けられます。