一致イベントと判定の違い
脅威インテリジェンスフィード(Threat Intelligence Feed)は、セキュリティベンダーや公開コミュニティが収集した悪性IPアドレス、ドメイン、ファイルハッシュなどの侵害指標のリストを定期的に配信するデータストリームです。このフィードをNDRと連携させると、既知の指標と通過するトラフィックが自動的に照合されます。
照合の結果として記録されるのは、指標とトラフィックが一致したという一致イベントだけです。ログやアラートが発生した状態しか示さないのと同じです。そのセッションで実際に何がやり取りされたのか、正常な業務通信がたまたま指標と一致しただけなのかは、一致イベントだけでは判別できません。フィードを追加してもこの限界は解消されません。リストが長くなるほど、根拠を確認できないアラートが積み上がり、アナリストの時間はアラートの検証に費やされます。
脅威インテリジェンスフィード運用の3つの要件
侵害指標(IOC、Indicator of Compromise)は、攻撃が差し迫っている、進行中である、あるいはすでに侵害が発生していることを示す技術的な痕跡(artifact)です。この範囲は米国国立標準技術研究所(NIST)の用語定義に沿ったもので、IETF(Internet Engineering Task Force)のRFC 9424は、さらに攻撃者の戦術と技法、使用するツールやインフラまでを観測の対象に含めています。フィードを運用資産として扱うには、次の3つの要件を満たす必要があります。
- 1. 判定:指標と一致したトラフィックが実際に悪性かどうかを確定できること。要約された情報だけで判定すると、正常なトラフィックが誤検知として報告される一方、偽装された悪性の振る舞いが検知漏れとして通過するという2つの誤りが同時に発生します。
- 2. 品質評価:どのフィードが運用環境で有効なのかを測定できること。世界中の攻撃指標を収集するフィードには、その組織の業種や地域に該当しない指標が多く混在しています。逆に、特定の業種を狙った指標がグローバルフィードに遅れて反映される場合もあります。
- 3. 廃棄:有効性を失った指標を識別し、リストから削除できること。数か月前に登録されたIPアドレスが現在は正常なサービスに移っているにもかかわらず、失効処理されずに残っていれば、その指標は検知ではなく誤検知を生み出します。
3つの要件は、いずれもフィードのリストそのものでは満たせません。リストは指標の存在を知らせるだけで、その指標が運用環境でどのように振る舞うのかは記録していないためです。
クロスチェックの実測上の限界
3つの要件をリスト内で解決しようとする一般的な方法がクロスチェックです。複数のフィードに共通して現れる指標を信頼し、1か所にしかない指標は低く評価する方式がこれにあたります。ルール自体は合理的ですが、実際のフィードを大量に比較した研究は、このルールを適用する対象そのものがほとんど存在しないという結果を報告しています。
商用フィードと公開フィードをあわせて収集し、同じ指標がいくつのフィードに現れるかを測定した研究によると、スキャン系の指標は73%、ブルートフォース(brute force)系は88%が単一のフィードにしか存在せず、ボットネット、脆弱性攻撃、マルウェア、スパムの各系統ではその割合が97%を超えていました(USENIX Security 2019 に基づく)。同じ研究では、この4つの系統についてフィードを2つずつ組み合わせて比較したところ、組み合わせの4分の3以上で共通部分が1%未満でした。どの2つのフィードを選んでも、含まれる指標は事実上重ならないということです。
フィードの品質評価に関する研究も、約138万件の指標のうち、2つ以上のフィードに登録されていたものは6.2%にとどまったと報告しています(ACNS 2020 に基づく)。同じ研究は、悪性活動の開始からフィードへの登録までに平均21日かかったという測定値もあわせて示しています。
2つの結果をあわせると、クロスチェックの役割が定まります。複数のフィードで共通して確認された指標は信頼性が高いものの、その割合が低いため、一次検証の手段としては適しません。登録の遅れが21日程度であれば、リストの最新性をリスト内で保証することは困難です。3つの要件の入力は、リスト以外のデータ、すなわちその指標と一致したトラフィックの実際の通信内容から得られます。
第1の要件 ― 判定:元のデータに基づく正誤判定の手順
一致イベントが発生したら、元のデータまで確認する手順で進めます。アラートごとに処理が変わることはないため、誤検知と検知漏れは最終的な判定の段階でともに識別されます。5つのステップの構成は[図1]のとおりで、自動化区間とアナリストの判定区間に分かれます。
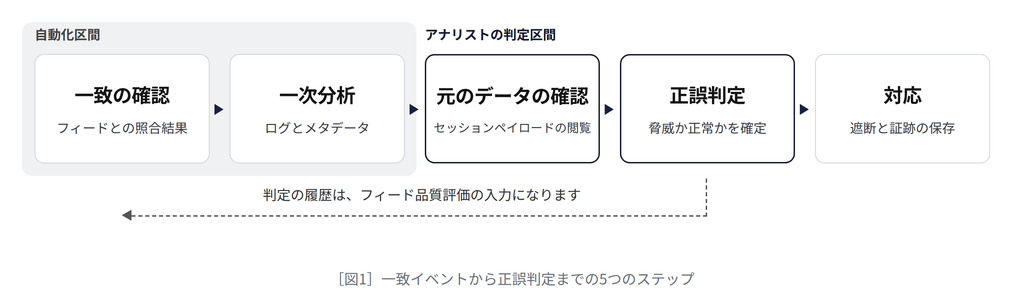
[図1]の自動化区間、すなわち一致イベントを確認し、ログとメタデータで疑わしい範囲を絞り込む段階までが自動的に処理されます。それ以降はアナリストが担当します。該当セッションの元のパケットを照会して実際の通信内容を確認し、ペイロードに悪性の振る舞いが現れていれば脅威、正常な業務通信と判明すれば誤検知と判定します。脅威と確定したものだけを、遮断と証跡の保存へ引き渡します。
元のトランザクション/セッションが保存されていれば、この段階は確定的な証拠(definitive evidence)に基づく判定になります。判定の要件を満たすには、リストの品質よりも先に、元のデータをどこまで保存しているかを確認する必要があります。
判定の履歴が蓄積されれば、判定結果のほかに、フィードごとの誤検知の発生率や、指標の種類ごとの有効期間も運用環境の数値として算出できます。前者は品質評価の要件が、後者は廃棄の要件が、それぞれ入力として使用します。
第2の要件 ― 品質評価:運用環境で測る5つの軸
フィードの品質は5つの軸に分けて評価します。業界で確立された単一の標準フレームワークはなく、学術分野では適時性・感度・独自性・影響という4つの次元で測定する方式(ACNS 2020)や、8つの指標に分ける方式(FeedMeter, ICISSP 2024)が示されています。[表1]の5つの軸は、こうした議論を運用の観点から再構成したものです。
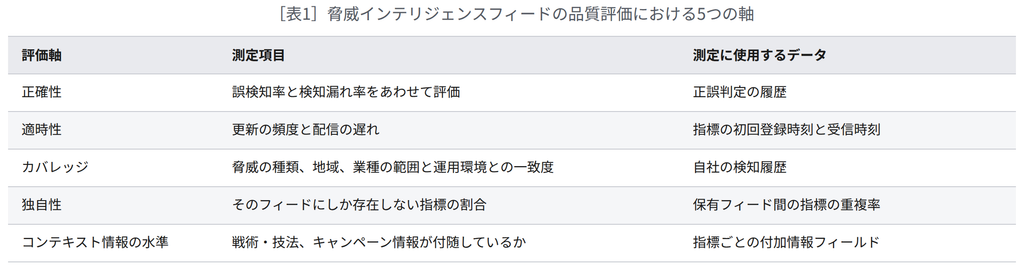
5つの軸は、測定に使うデータがそれぞれ異なります。正誤判定の履歴を入力とするのは正確性の軸だけで、残りの4つの軸は、指標の受信時刻、自社の検知履歴、フィード間の重複率、指標に付随する付加情報からそれぞれ算出します。1つの軸だけを見てもフィードの一面しか分からないため、5つの軸をあわせて評価します。
品質とは別に、連携の形式もあわせて確認します。STIX(Structured Threat Information Expression)2.1とTAXII(Trusted Automated Exchange of Intelligence Information)2.1は、2021年にOASIS標準として公表された現行の規格であり、対応形式を確認しなければ、品質の高いフィードであっても運用パイプラインに連携できません。
同じ履歴から、適用の優先順位も決めます。すべての指標を同じ等級で適用すると、アラートの量が判定の処理能力を超えます。組織の業種や保有資産に関連する指標を優先して適用し、攻撃の戦術・技法に結び付いていて検知後の分析で活用度が高い指標は順位を上げ、生成や更新の時点が古い指標は順位を下げます。複数のフィードで共通して確認された指標に加点することは有効ですが、該当する指標が少ないため、順位付けの主たる基準にはしません。
適用の範囲は段階的に広げ、信頼性が確認されていない指標は遮断ポリシーに直ちに反映しません。まずは検知とモニタリング専用に適用して実際の一致履歴を蓄積し、元のデータを確認して正誤を判定したうえで、遮断ポリシーへ移行します。品質評価の要件も、判定の履歴という同じ入力から満たされます。
第3の要件 ― 廃棄:指標の種類ごとの有効期間と陳腐化の基準
種類ごとの見直し周期と、廃棄を判断するシグナルをあわせて定めておきます。攻撃者がインフラを入れ替えたり、ドメインが再利用されたりすると、同じ値が正常なリソースを指すようになります。有効性を失った指標を残しておけば、誤検知が増え、照合の負荷も大きくなります。見直しの周期は指標の種類ごとに変えて設定します。指標にスコアを付けて時間の経過とともに値を下げていく減衰モデルでも、フィード提供者が独自に定めた有効期間のポリシーでも、IPアドレスは短く、ファイルハッシュは長く設定されています。
ただし、ハッシュの有効期間が長いことを、ハッシュで長く検知できるという意味に読み替えてはなりません。そのハッシュが指すファイルが悪性であるという判定は長く有効ですが、検知手段としての有用性はむしろ最も低いものです。RFC 9424は、攻撃者がコードを再コンパイルしたり、ファイルの内容を一部変更したりするだけでハッシュベースの検知を無効化できると指摘し、ハッシュを最も脆弱な指標に分類しています。判定の有効性と検知の有用性を区別しなければ、廃棄の周期は不正確に見積もられます。種類ごとの整理は[表2]のとおりです。
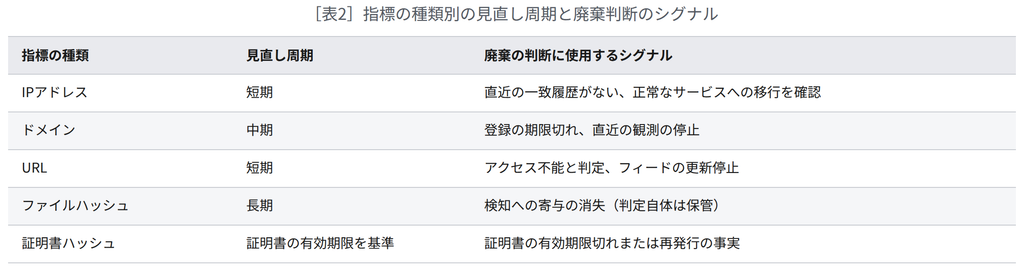
[表2]の見直し周期を日数として確定する際、外部の値をそのまま適用することは困難です。よく引用される数値は、算出の根拠がそれぞれ異なります。減衰モデルを提案したMISP側の論文にあるIPアドレス7日、ハッシュ60日は、モデルを説明するための例示値であり、論文自体がデータセットの分析によって再調整すべき値だと明記しています(CIRCL 2018 に基づく)。
MISPの標準的な侵入検知モデルでは、ドメイン、IPアドレス、URLに同じ有効期間120日が適用されます。論文が挙げた例示値と、ツールに既定値として設定されている値は性格が異なり、種類ごとの標準的な日数も確立されていません。基準値は自社の判定履歴から算出する必要があります。
算出した基準値には、2つのポリシーを併用します。時間ベースの失効は設計が単純である一方、有効な指標を早期に削除してしまうリスクがあります。減衰ベースの廃棄は、新たな観測があればスコアを元の値に戻すため、このリスクを小さくします。MISPの減衰モデルは、有効期間、減衰の速度、閾値をパラメータとして、この方式で動作します。時間ベースの失効を一次条件、減衰スコアを二次条件として組み合わせます。
廃棄の前には、廃棄予定の指標で過去のトラフィックを先に照会する段階を設けます。遡及再検査は、新たに取得した指標で、保存された過去のパケットやセッションを再度分析する手順であり、元のデータが保存期間内に残っていることが前提です。照会の結果、一致履歴が残っていれば、廃棄せず保管に切り替えます。一致履歴のある指標を削除すると、事後調査の参照根拠もあわせて失われます。
元のデータを保存しておく利点は、廃棄の判断以外にも及びます。PCAP(Packet Capture)単位の元のデータが残っていれば、脆弱性が事後に公開された場合でも、公開以前に侵害があったかどうかを判別できます。廃棄の要件は、リストの失効日ではなく、元のデータの照会結果が満たします。
自律型セキュリティ運用の根拠:リストと元のデータを結び付ける入力構造
3つの要件は、いずれもフィードが配信する指標リストでは満たせません。判定は元のデータの確認から、品質評価はその判定の履歴から、廃棄の判断は過去のトラフィックの照会から導かれます。出どころは3つとも異なりますが、いずれも元のトラフィックを根拠としています。3つの要件をあわせて満たすには、指標が一致した時点の元のトランザクション/セッションが、判定の時点でも、その後の照会の時点でも保存されている必要があります。
この構造が整ってはじめて、判定の自動化が根拠の上に成り立ちます。攻撃の実行が自動化されるほど、アナリストが指標を個別に確認して判定するサイクルでは対応の速度を合わせることが難しくなり、検知から分析、判断、対応へとつながるClosed-Loop自動化、すなわち自律型セキュリティ運用(Autonomous Security Operations)が必要になります。一致イベントだけでは、その判断は確定しません。
フィード運用の課題は、良質なリストの確保から、リストと元のデータを結び付ける構造の確保へと移ります。自律型セキュリティ運用で先行するための条件は、対応の速度よりも入力データの完全性です。
よくあるご質問
Q. フィードを複数導入すれば、検知の範囲は広がらないのでしょうか。
指標の数は増えますが、判定の処理能力が同時に増えなければ、確認できないアラートが積み上がるだけです。フィードを追加する前に、現在のフィードについて正誤判定の履歴をそろえて[表1]の5つの軸で評価し、既存のフィードと重複しない範囲かどうかを確認する、という順序をおすすめします。
Q. 廃棄した指標を後から再度確認する必要が生じた場合、どのように備えればよいですか。
指標を廃棄しても、その指標で判定した履歴と一致履歴は別に保管します。元のトラフィックが保存期間内に残っていれば、新しい指標で過去の区間を再度照会できるため、廃棄のポリシーと元のデータの保存期間はあわせて設計する必要があります。