ログとアラートの限界:推定にとどまるSOCの判断構造
2025年の1年間に世界の組織が受けたサイバー攻撃は、1組織あたり週平均1,968件で、2023年より70%増加しました(Check Point Cyber Security Report 2026 に基づく)。セキュリティ専門人材の不足規模は480万人と推計されています(ISC2 2024 Cybersecurity Workforce Study に基づく)。攻撃は速く、そして多くなる一方で、対処する人材はそれに見合うほど増えません。あらかじめ定義したルールと、人手を介したアラートトリアージに依存する運用では、対応の初動時間を守ることが困難です。AIエージェントによるSOC自動化が代替案として議論される背景は、ここにあります。
自動化そのものが解決策になるわけではありません。今日のSOCの判断は、その大半がログやアラート、イベントといった状態情報に基づいて行われています。ログとアラートだけを入力として受け取る判断は、アナリストが行ってもAIが行っても推定にとどまります。ログとアラートが示すのは、何が起きたのかという発生状態までです。実際に何がやり取りされたのか、平常時とどれだけ異なっていたのか、なぜそう判定したのかは分かりません。この3つを埋めるコンテキストデータがそれぞれの役割で根拠を与え、3つがそろって入力されたとき、判断の自動化に必要な根拠がより完全なものになります。根拠が不十分なまま速度だけを上げれば、速くなるのは判断ではなく推定です。
エージェンティックAIと単純な自動化の違い
エージェンティックAIは、目標を与えると自ら計画を立てて実行する自律実行型のAIです。あらかじめ定めたルールではなく、その時点の状況判断によって次の行動を決めます。SOAR(Security Orchestration, Automation and Response)のプレイブックは、あらかじめ定義された条件が満たされたときにのみ動作します。はじめて見る攻撃パターンや、条件の組み合わせが変わった状況では、対応の流れがその条件のところで止まります。エージェンティックAIは、その場面でコンテキストを推論し、判断を継続します。
自律性には条件が伴います。プレイブック自動化において判断を代替していたのは、人が定義した条件でした。エージェンティックAIは、その判断を自ら行います。そのため、入力データの品質がそのまま結果の品質になります。アラートの要約のように現象だけを含むデータを受け取れば、AIの推論もその要約の範囲にとどまります。元のトラフィックとセッションまで受け取れば、実際にやり取りされた振る舞いを根拠として判定します。構造が同じでも、入力によって判断の信頼度は変わります。
セキュリティ運用の5段階と自動化の適用ポイント
SOCの運用は、収集、検知、アラートトリアージ、詳細調査、対応の5段階で構成されます。AIエージェントの役割は段階ごとに異なります。
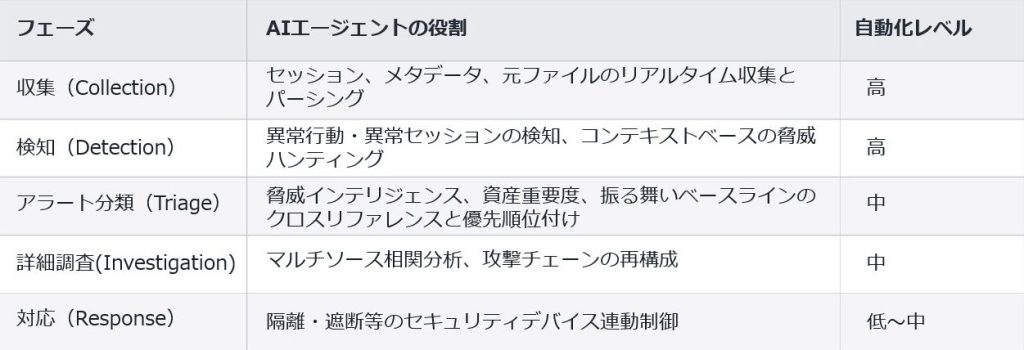
収集と検知は、自動化の効果が最も大きい区間です。アラートトリアージでは、AIが脅威インテリジェンスと資産の重要度、振る舞いのベースラインをクロス参照し、アナリストが確認すべき範囲をあらかじめ絞り込みます。調査時間がどれだけ短縮されるかは入力データと運用環境によって変わるため、単一の数値としては提示しません。隔離と遮断は、これらとは性格が異なります。誤検知1件が業務継続性に直接影響するため、現在の運用環境では、AIが措置を提案し、実行の承認は人に残す半自律型の構造が現実的です。
同じエージェンティック構造でも判断品質が分かれる要因
入力が異なれば、運用が引き受けるリスクも変わります。アラートの要約だけを受け取るAIは、現象を説明することはできても、原因まで確定することは困難です。この構造では誤検知が増え、AIのハルシネーションが発生する可能性も高まります。自律実行のレベルを上げるほど、その負担は大きくなります。誤った推定が人のレビューを経ずに、そのまま次の行動につながるからです。
AIが参照すべきコンテキストデータは3つです。実際に何がやり取りされたのかを記録した元のトランザクション/セッションデータ、平常時と比べた逸脱の方向と大きさを示す振る舞いのベースラインデータ、その判定に至った経路を残す検知の説明性(XAI)データです。それぞれのコンテキストデータが固有の役割でアラートトリアージの根拠を与え、3つがそろって入力されたとき、クロス参照によって誤検知の負担をさらに軽減します。1つでも欠ければ、その役割が担う根拠が不足する分だけ、判定の信頼性は低下します。入力の完全性が判断品質の上限を決めるという原則は、エージェンティック構造でも変わりません。
導入時の検討基準:自律レベルとガバナンス
AI SOCエージェントを評価する際によく見られる項目は、調査の深さ、自律制御のレベル、フィードバックループ、デプロイモデル、価格体系です。この評価でよく繰り返される誤りが1つあります。MITRE ATT&CKのカバレッジ数値やアラートの発生件数を、検知能力の代表的な指標としてしまうことです。カバレッジが示すのは、検知ルールがどこまで定義されているかにすぎません。検知ルールを回避する攻撃や、正常なアカウントを使う内部の異常な振る舞いをコンテキストから検知できるかどうかは、別の問題です。エージェンティックな自動化であれば、次の3点をあわせて確認する必要があります。
- 自律実行の範囲を段階ごとに調整できるか:提案のみを行うレベル、承認後に実行、完全自律まで、シナリオごとに分けて制御できる必要があります。
- 誤検知のフィードバックが次の判断に反映されるか:アナリストの判定結果が学習に戻らなければ、同じ誤検知が繰り返されます。
- AIの判断を人が検証する手段があるか:判断の根拠を提示できないエージェントは、自律範囲が広いほど監督が難しくなるため、検証手段を先に確認します。
この3つの基準を1つにまとめたものがガバナンスです。AIのハルシネーションや、プロンプトインジェクションのような悪意ある命令の注入を遮断する内部検証体制がなければ、自律実行の範囲を広げた分だけ、誤った判断もそのまま措置として実行されます。
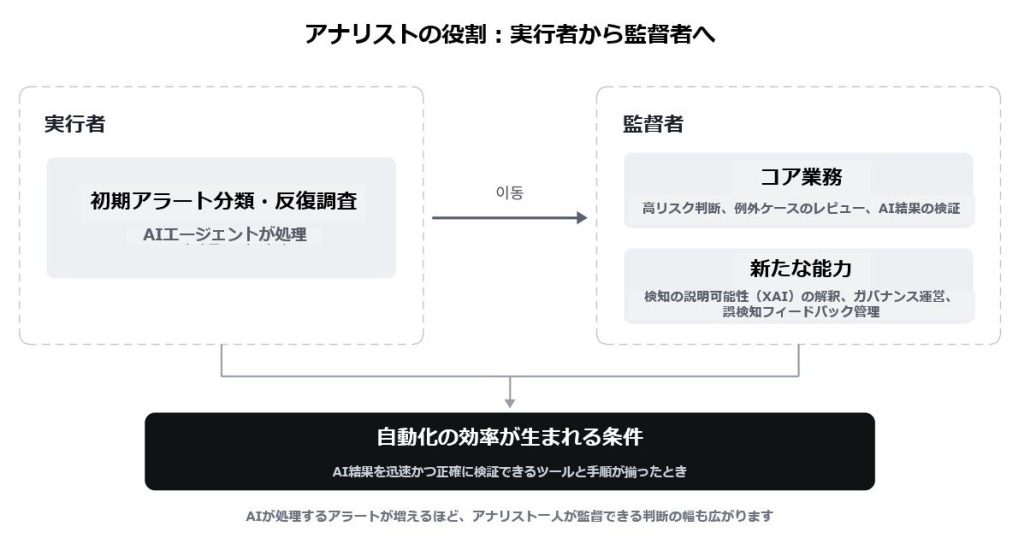
アナリストの役割:実行者から監督者へ
AIエージェントが一次のアラートトリアージと反復的な調査を担うようになると、アナリストの役割は実行者から監督者へと移ります。高リスクな判断と例外ケースのレビュー、AIの結果の検証が本業となり、検知の説明性(XAI)の解釈とガバナンスの運用、誤検知フィードバックの管理が新たなスキルとして加わります。確認すべき点が1つあります。AIが処理するアラートが増えるほど、アナリスト1人が監督する判断の範囲も同じように広がります。自動化の効率は、AIの結果を迅速かつ正確に検証する道具と手順がそろってはじめて得られます。
規制環境:韓国、日本、米国、EUに共通する要求事項
規制要件が厳格な環境では、確認すべきことがもう1つあります。管轄ごとに規制の名称は異なりますが、求めるところは共通しています。インシデントを定められた期限内に報告すること、判断の土台となった記録を定められた期間保存すること、監査や調査の場で提示することです。
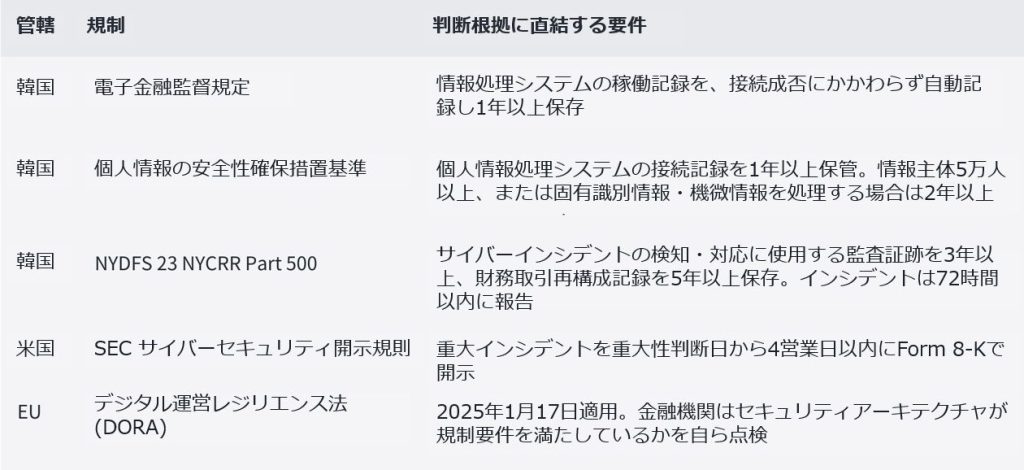
保存期間と報告期限は管轄ごとに異なりますが、前提は1つです。調査に提出できる記録が残っていなければなりません。ここにAIが判断を担うようになると、条件が1つ増えます。AIが脅威と判定した根拠までを、規制監査やインシデント調査にそのまま提出できなければなりません。元のトラフィックのレベルで再現されない判定は、技術的な根拠として使うことが困難です。報告期限が日本の個人情報保護法の3日から5日であれ、米国NYDFS Part 500の72時間であれ、SEC開示規則の4営業日であれ、その期限内に根拠を確保して説明できなければ、期限を守っても提出する内容がありません。そのため規制環境では、PCAP(Packet Capture)単位のフォレンジックデータを確保できるかどうかが、ソリューション選定の中心的な基準になります。
推定の自動化から判断の自動化へ
攻撃が自動で生成され実行される水準にまで速くなり、人が行う検知と調査、対応だけでは速度を合わせることが困難になっています。AIエージェントによるSOC自動化を検討するなら、確認すべきことは3つです。
- 段階別の適用:収集と検知、アラートトリアージから自動化し、対応はAIが提案して実行の承認は人に残す半自律型の構造から始めます。
- 監督体制:自律範囲の調整とフィードバックループ、判断の検証手段とガバナンスを、導入前に整えます。
- 入力データ:元のトランザクション/セッションデータと振る舞いのベースラインデータ、検知の説明性(XAI)データがAIの入力として入ってくるかを確認します。
構造が同じでも、結果は入力で決まります。アラートの要約を入力すれば推定が自動化され、3層のコンテキストデータを入力すれば判断が自動化されます。SOC自動化をもう一段引き上げるには、AIの実行範囲よりも先に、そのAIが参照できるコンテキストデータの範囲を広げる必要があります。検知から分析、判断、対応へとつながるClosed-Loop自動化、すなわち自律型セキュリティ運用(Autonomous Security Operations)も、このように確保した根拠の上で動作します。そのためSOC自動化を検討する際は、どのAIを選ぶかよりも先に、そのAIが何を入力として受け取るのかを確認する必要があります。
よくあるご質問
Q. AIエージェントによるSOC自動化と、従来のSOARの違いは何ですか。
SOARは事前に定義されたプレイブックの条件でのみ動作しますが、AIエージェントは条件が明示されていない新しい攻撃パターンにもコンテキストを推論して対応します。実務で差が出るのはその先です。自律実行の範囲を段階ごとに制御し、判断を検証する監督体制をあわせて備える必要があります。
Q. AI SOCエージェントを導入すれば、セキュリティアナリストは不要になりますか。
反復的なアラートトリアージと一次調査は自動化されます。高リスクな判断と例外ケースのレビュー、AIの結果の検証は人の役割として残ります。アナリストの役割が実行者から監督者へ移るのであって、なくなるわけではありません。
Q. 金融機関や公共機関がAIによるSOC自動化を導入する際、特に確認すべきことは何ですか。
AIの判定根拠となる元のデータ、すなわちPCAP単位のフォレンジックデータを確保できるかどうかが中心的な基準です。韓国国内の機関であれば、まず「個人情報の安全性確保措置基準」によるアクセス記録の保管要件が適用され、海外事業もあわせて行う組織は、日本の個人情報保護法の漏えい報告期限、米国NYDFS Part 500の監査証跡要件、EUのDORAまで確認する必要があります。いずれの場合も、内部ネットワークの可視性とフォレンジック対応能力を同じ基準で点検する必要があります。