ログとアラートの限界と、推定に基づく判断
今日のセキュリティ運用の大半は、ログとアラートをもとに行われています。ログ、アラート、イベントはいずれも「特定の時点で何かが起きた」ことを示す状態情報です。問題は判断です。ログとアラートだけでは、その事象が実際の脅威なのか、どのような経路で進行したのか、被害がどこまで及んだのかを確認できないため、アナリストもAIも推定に頼ることになります。推定に基づく判断は誤検知の処理負担を増やし、追加調査も必要になるため、実際の脅威への対応が遅れます。
AIベースのセキュリティ監視も、同じ構造の上で動作します。モデルがどれほど精緻でも、入力データがログとアラートの水準にとどまるのであれば、判断の根拠は脆弱にならざるを得ません。必要なのは、推定に依存していたAIの判断を、実際の振る舞いと明確な根拠に基づく判断へと転換できるコンテキストデータです。
AIベースのセキュリティ分析と判定の信頼性は、モデル自体よりも、実際の振る舞いと判断根拠を提供するコンテキストデータによって左右されます。本記事では、ログとアラート中心の分析が抱える限界を確認したうえで、元のトランザクション/セッションデータ、振る舞いのベースラインデータ、検知の説明性データがそれぞれどのような役割を果たすのか、そして互いに組み合わさったときにAIの分析と判定の信頼性をどのように高めるのかを、データフローの順に説明します。
ログとアラートでは説明できない発生原因
SIEM(Security Information and Event Management)は、組織内のセキュリティ機器やシステムのログ、イベントを収集し、相関分析によって脅威を検知するセキュリティイベント統合管理プラットフォームです。この定義の時点で、すでに限界が表れています。SIEMが収集するログとイベントは特定の時点の発生状態を示しますが、実際の通信内容や攻撃者の振る舞いの順序、被害範囲をそれ単独で説明することは困難です。
セキュリティアナリストがイベントを確認した後に直面する問題も、この点から始まります。アラートを1件受け取ると、そのイベントの原因を把握するために、ファイアウォールのログ、IDS/IPSのイベント、エンドポイントの記録など、複数のセキュリティ機器を順に照会しなければなりません。各システムでデータ形式が異なるため、同一の脅威に関連する情報をつなぎ合わせて分析するには時間がかかり、その間に攻撃者はすでに次の段階へ移っている可能性があります。
従来のセキュリティ機器は、あらかじめ定義されたシナリオや検知ルールに該当するイベントだけを記録します。そのため、未知の攻撃パターンや、正常なプロトコルを悪用した内部者の振る舞いについてはログが生成されない場合があり、こうした振る舞いは、発生の有無や具体的な経緯を事後に追跡することがいっそう困難になります。一方、記録されたイベントについても限られた情報だけで判断せざるを得ないため、誤検知のアラートが増える可能性があり、アナリストは脅威かどうかを確認するために手作業での追加調査に依存することになります。さらに、元のパケットやセッションデータまで取得できていなければ、実際の振る舞いと攻撃経路を検証することも困難です。
結局のところ、ログ中心の分析は「何が発生したのか(WHAT)」を記録するにとどまります。セキュリティAIが脅威の原因と影響を判断するには、「なぜ発生したのか(WHY)」を説明できるデータが別途必要です。
コンテキストデータとは何か:3層構造の概要
コンテキストデータとは、AIベースのセキュリティ分析と判定に必要な、実際の振る舞いの証拠、正常か異常かを判断する基準、そして判断根拠の検証可能性を提供するデータです。ログがイベントの発生状態を示すものだとすれば、コンテキストデータは、実際にどのような振る舞いが発生したのか、正常範囲からどれだけ逸脱しているのか、そして脅威かどうかを判断できる根拠は何かを示します。
Quad Minersは、フルパケット収集データを基盤として、コンテキストデータを元のトランザクション/セッション、振る舞いのベースライン、検知の説明性という3つの層で構成しています。各層は、実際の振る舞いの証拠、正常範囲からの逸脱の度合い、AI判断に対する検証根拠を提供し、分析と判定の信頼性を高めます。
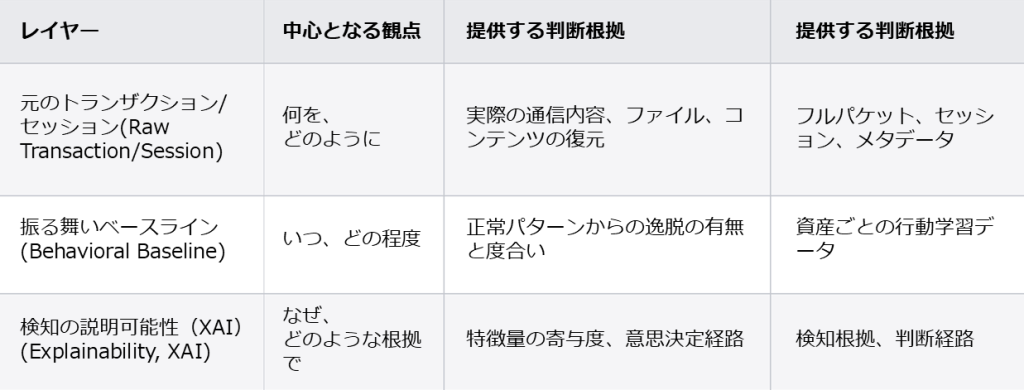
3つの層は、それぞれ独立した役割を果たしながら、1つのデータフローとしてつながります。前の層の出力が次の層の判断根拠になるため、あわせて備えるほど判定の精度と信頼性が高まります。
元のトランザクション/セッションデータと振る舞いの証拠
ログが「何が発生したのか」を記録するものだとすれば、元のトランザクション/セッションデータは「何が、どのように発生したのか」を確認するためのデータです。実際の脅威を調査する過程で、この違いは明確になります。ログには、特定のIPから大容量のデータ転送が発生したという状態は記録されますが、どのファイルがどの経路でどこへ転送されたのかは、元のパケットとセッションを分析しなければ確認できません。
この層は、ネットワークトラフィックをフルパケットで収集し、L7レベルでセッション、ファイル、メール、コンテンツを再構成することで、実際の振る舞いに関する確定的な証拠を提供します。トラフィック量や接続情報の記録にとどまらず、実際の通信でやり取りされたファイルやコンテンツの本文まで復元する構造です。これにより、アナリストは不審なイベントが発生した時点で実際にどのようなデータが移動したのかを、元のデータのレベルで確認できます。
Rebuild(遡及再検査)機能も、この層で重要な役割を果たします。新たな脅威指標(IOC)が発見された際、保存されている過去のパケットとセッションを再分析すれば、その脅威がすでに内部ネットワークで活動していたかどうかを事後に確認できます。PCAP(Packet Capture)単位で証拠を確保しておくことは、インシデント対応やフォレンジック分析において攻撃経路を再現する根拠になります。ただし、フルパケットの保管範囲と保存期間は構築環境や仕様によって異なるため、導入時には実際の運用環境を基準に設計する必要があります。
振る舞いのベースラインデータと逸脱の測定基準
振る舞いのベースラインは、資産およびユーザーごとの正常な通信パターンを学習し、逸脱の有無と逸脱の度合いを判断するための基準データです。固定的な検知ルール方式と異なるのは、あらかじめ定義された攻撃パターンがなくても、正常な状態と異なる振る舞いを検知する点です。
ユーザーおよび資産ごとの通信相手と相互の通信区間を識別し、一定期間にわたって蓄積された通信量、接続時間、使用プロトコル、セッション数などの振る舞いのパターンを基準として、正常範囲と逸脱の度合いを判断します。たとえば、あるサーバーが正常な状態では業務時間帯にわずかな外部通信を行うだけだったのに、深夜の時間帯に大容量のデータを外部へ転送し始めた場合、検知ルールベースの検知では見逃す可能性がありますが、振る舞いのベースラインはこれを逸脱として検知します。この違いは、内部者による異常な振る舞いや、正常なプロトコルを悪用した攻撃のように、従来の検知ルールだけでは識別が難しい脅威を分析する際に、いっそう明確になります。
振る舞いのベースラインデータは、一定期間学習した正常な振る舞いのパターンを現在の振る舞いと比較し、正常範囲から逸脱した度合いを、AIが分析・判定するための根拠として提供します。逸脱の度合いが定量化されれば、AIは正常か異常かを区別するだけでなく、異常のレベルや脅威の可能性をきめ細かく判断できます。元のトランザクション/セッションデータとあわせて活用すれば、実際の振る舞いと異常の度合いを結びつけて分析できるため、判定の信頼性はさらに高まります。
検知の説明性データとAI判断の検証
検知の説明性データは、脅威かどうかの判断に用いられた検知および判定の根拠と、AIの判断に影響を与えた主要なデータや特徴量の寄与度をあわせて提供するコンテキストデータです。アナリストはこれにより、脅威判定の妥当性を確認し、検証できます。
AIが脅威と判断したイベントについて特徴量ごとの寄与度を確認できれば、アナリストはその判断が実際の脅威の根拠に基づくものなのか、データのノイズに反応したものなのかを見分けられます。説明の根拠がないまま検知結果だけが提示される場合、この検証は行えず、誤検知の処理とAIの検証の負担がアナリストに残ります。
コンテキストデータとAIセキュリティ分析の品質
セキュリティAIの判断精度には、モデル自体の性能と同じくらい入力データの品質が重要です。ログと要約情報だけが入力される構造では、AI分析においても誤検知とハルシネーションが繰り返される可能性があります。ログとアラートだけでは攻撃のコンテキストを把握することが難しく、コンテキストのない判断は根拠の乏しい判断になります。
3層のコンテキストデータ、すなわち元のトランザクション、振る舞いのベースライン、検知の説明性は、AI分析とセキュリティオブザーバビリティ(Security Observability)を高度化するための根拠です。鍵となるのは、AIが判断できる形のデータが入力されるかどうかです。元のデータで実際の振る舞いを確認し、振る舞いのベースラインで逸脱の方向と大きさを数値で確認し、検知の説明性で判断の過程を遡って追跡できるとき、AIの結果は、人が毎回あらためて調査しなければならない提案ではなく、検証可能な判断になります。検知から分析、判断、対応までを1つのコンテキストの上でつなぐ自律型セキュリティ運用プラットフォームも、このコンテキストデータの上で動作します。
Quad Minersの差別化要素は、AI機能を追加したことではなく、元のトランザクション/セッションデータ、振る舞いのベースラインデータ、検知の説明性データを、AIの分析と判定に必要な根拠として提供できるデータアーキテクチャを備えている点にあります。競争力は、AIモデルの性能と同じくらい、コンテキストデータをどれだけ欠けることなく確保しているかにあります。
コンテキストデータがセキュリティAI分析にもたらす価値は、次の4つです。
- 判断精度の向上:元のトランザクションと振る舞いのベースラインがAI分析の入力品質を高め、誤検知を減らします。
- 検証可能性の確保:検知の説明性データにより、AI判断の根拠と過程をアナリスト自身が確認し、検証できるようになります。
- 過去トラフィックの再検査(retrospective re-analysis)の支援:保存された元のパケットとセッションをもとに、新たな脅威指標を過去のトラフィックに適用し、潜伏する脅威を遡って追跡します。
- 証拠の確保:PCAP単位の元のデータが、インシデント対応とフォレンジック分析の技術的根拠になります
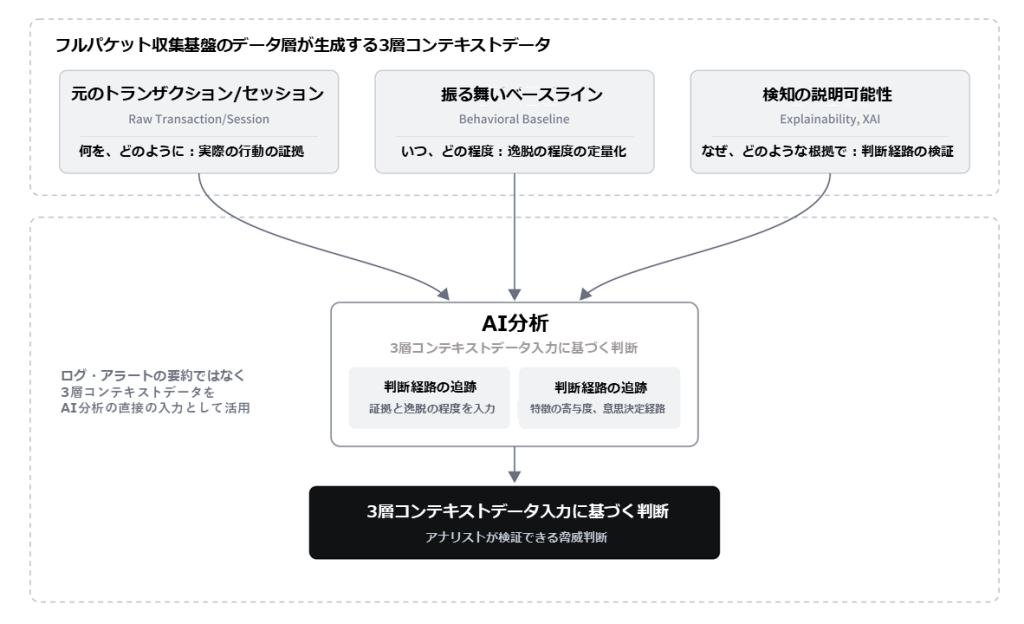
このアーキテクチャの目標は明確です。検知から分析、判断、対応へとつながるClosed-Loop自動化、すなわち自律型セキュリティ運用(Autonomous Security Operations)です。AIが自ら判断し対応する運用体制は、信頼できる判断根拠の上で機能し、3層のコンテキストデータがその根拠を提供します。
セキュリティAI導入前のデータアーキテクチャ点検チェックリスト
AIベースのセキュリティ監視やNDR(Network Detection and Response)、SIEMプラットフォームの導入を検討する際、機能一覧を比較するだけでは十分ではありません。規制遵守要件(韓国および日本の個人情報保護法、米国のHIPAA、EUのGDPR、PCI-DSSなど)、脅威インテリジェンスフィードの統合、機械学習ベースの検知、SOAR(Security Orchestration, Automation and Response)との連携可否といった一般的な選定基準とあわせて、「判断根拠となるデータをどのように確保するのか」というデータアーキテクチャの観点からの基準も検討する必要があります。
以下のチェックリストは、データアーキテクチャの観点から確認すべき主要な問いを、3層のコンテキストデータにマッピングしたものです。
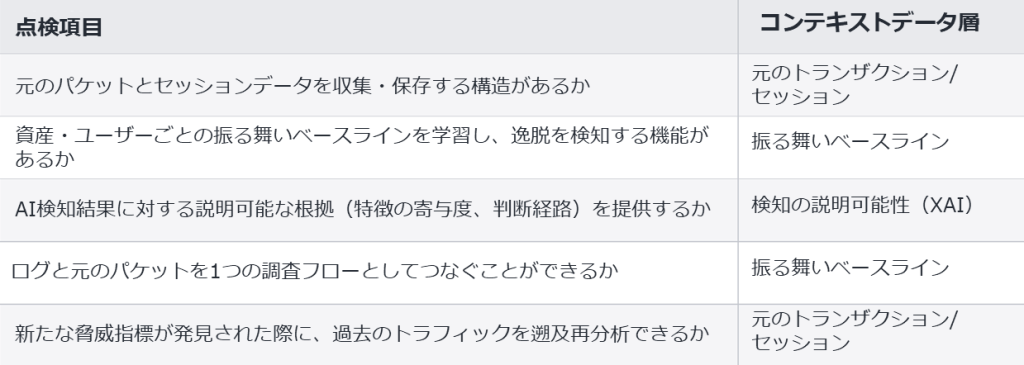
各項目は、独立した機能の確認ではなく、互いにつながったデータフローの一部です。元のパケットを収集する構造がなければ過去トラフィックの再検査の範囲が限られ、振る舞いのベースラインがなければ逸脱の度合いを定量化する根拠が不足し、検知の説明性がなければAIの判断を検証する根拠が不足します。導入検討の段階でこの5つの項目が1つのデータフローとしてつながっているかを確認することが、AIベースのセキュリティ監視の実質的な出発点です。
収集から自律型セキュリティ運用まで:3層コンテキストデータを実装した3つの製品
3層のコンテキストデータは概念モデルではなく、収集、保存、分析の構造を備えてはじめて得られるデータです。Quad Minersの3つの製品は、この3つの層を生成し、組織全体のログと連携させ、AIの分析と判定に必要な根拠として活用するという順序で構成されています。
- Network Blackbox (NDR):生成 フルパケットの収集と保存、L7再構成によって、元のトランザクション、振る舞いのベースライン、検知の説明性という3つの層を生み出す起点です。
- QUADX (Context-Aware NGSIEM):連携 こうして生成されたコンテキストデータを、組織全体のログ、イベントと1つの流れとしてつなぎ、「なぜ発生したのか」まで調査できるようにします。
- QUADxAI(ロードマップ):判断 3つの層をAIの分析と判定に必要な根拠として利用する、コンテキストデータ中心のAIベースのセキュリティオブザーバビリティプラットフォームで、ロードマップに沿って開発を進めています。
攻撃が自動化されるスピードに、アナリストが順に調査していく運用で追いつくことは困難です。検知から分析、判断、対応までが1つのコンテキストの上でつながる自律型セキュリティ運用が必要であり、そのためにはAIが自ら判断できなければなりません。そして、その判断の根拠となるのは、ログとアラートではなく3層のコンテキストデータです。検知中心のセキュリティ運用から自律型セキュリティ運用へと進むための根拠がコンテキストデータであり、Network BlackboxからQUADXを経てQUADxAIへと続く道筋は、その根拠を段階的に確保してきた過程です。
よくあるご質問
Q. コンテキストデータに基づくセキュリティAI分析とは何ですか。
コンテキストデータに基づくセキュリティAI分析とは、ログやアラートの要約ではなく、元のトランザクション、振る舞いのベースライン、検知の説明性のデータを、AIの分析と判定に必要な根拠として活用し、脅威の原因と影響を判断する方式です。Quad Minersは、フルパケット収集を基盤として生成される3層のコンテキストデータによって、この構造を実装しています。
Q. 検知の説明性データがセキュリティ監視に必要な理由は何ですか。
検知の説明性データは、AIが脅威と判断した根拠と過程を、アナリストが直接確認できるようにします。AIの判断を無条件に信頼するのではなく、アナリストが検証し、実際に対応するかどうかを決定するための根拠になります。説明可能な根拠がないまま検知結果だけが提示される場合、誤検知の処理やAIの検証が難しくなり、アナリストの判断負担はかえって大きくなる可能性があります。
Q. セキュリティAIの導入時に、データアーキテクチャを先に検討すべき理由は何ですか。
AIによるセキュリティ分析の判断品質は、モデル自体だけでなく、モデルに入力されるデータの品質とコンテキストによって決まります。そのため、元のパケットの収集、振る舞いのベースラインの学習、検知の説明性の提供という構造が備わっているかを先に確認する必要があります。ログと要約情報だけが入力される構造では、AI分析においても誤検知や判断の誤りが繰り返される可能性があります。