수집되지 않는 구간과 조사 범위 제약
침해 조사는 경보 발생 시점의 통신 내용을 확인하는 데서 시작합니다. 이때 해당 구간의 패킷이 저장되어 있지 않으면 조사는 로그와 경보가 기록한 범위에서 끝나고, 전송 파일과 전송 경로는 확인할 수 없습니다.
대용량 트래픽 환경에서는 풀패킷 저장 방식을 적용한 뒤에도 이 상황이 발생합니다. 수집과 저장 과정에서 손실된 패킷은 이후 단계의 어떤 분석 엔진으로도 복원되지 않으므로, 손실이 발생한 구간에는 원본 데이터 자체가 존재하지 않습니다. 원본 트랜잭션/세션 데이터와 행위기준선 데이터, 탐지설명성(Explainability, XAI) 데이터로 이루어진 3계층 맥락데이터도 저장된 패킷에서 생성됩니다. 수집과 저장 설계가 판단의 입력 범위를 정합니다.
패킷 손실이 발생하는 세 지점
패킷 손실은 수집, 저장, 데이터 연동의 세 지점에서 발생하며, 지점마다 손실되는 대상과 복구 가능 여부가 다릅니다. 구분은 [표 1]과 같습니다.
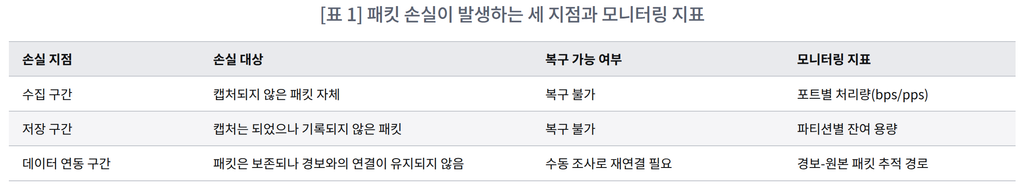
앞의 두 지점에서 발생한 손실은 데이터 자체가 남지 않는 손실이므로 사후에 복구할 수 없고, 설계 단계에서만 예방할 수 있습니다. 셋째 지점의 손실은 데이터가 남아 있는 상태에서 경보와 원본의 연결이 유지되지 않는 경우이므로, 수동 조사로 다시 연결하면 복구됩니다. 앞의 두 지점은 데이터 확보, 셋째 지점은 조사 비용에 해당합니다.
첫째 지점, 수집: 캡처 방식과 센서 대수
첫째 지점인 수집에서는 캡처 방식을 먼저 결정합니다. 패킷 캡처는 네트워크를 통과하는 패킷을 복제해 기록하는 기술이며, 방식에 따라 손실 여부와 운영 영향, 장기 운용 적합성이 달라집니다. 비교는 [표 2]와 같습니다.
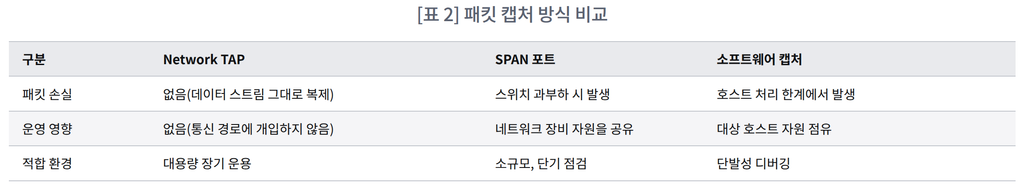
대용량 구간에서는 [표 2]의 세 방식 가운데 네트워크 장비 자원을 공유하는 SPAN 포트 방식이 먼저 한계에 이릅니다. 트래픽이 집중되는 시간대에 스위치의 처리 용량을 초과하면 손실이 시작되고, 그 구간의 패킷은 복구되지 않습니다. 장기 운용 구간에는 통신 경로에 개입하지 않고 데이터 스트림을 그대로 복제하는 방식을 적용합니다.
이어서 결정할 항목은 센서 대수입니다. 센서 1대의 처리 대역폭을 초과하는 구간에서는 트래픽을 여러 대로 분산해야 하며, 분산 방식은 구간 유형에 따라 달라집니다. Network Blackbox의 수집 경로 구성은 [그림 1]과 같습니다.
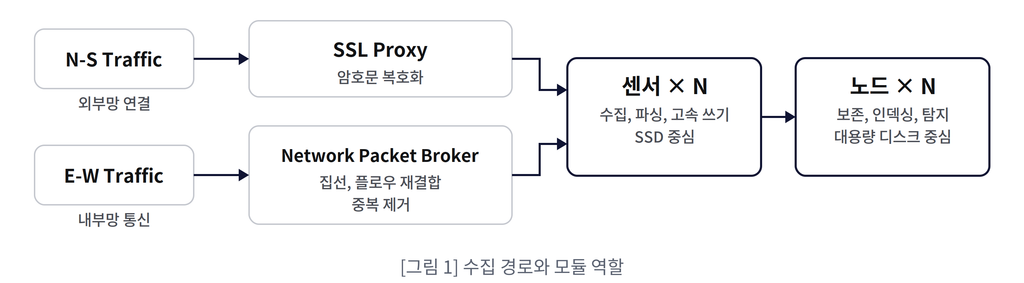
[그림 1]의 상단 경로는 외부망과 연결되는 남북(North-South) 트래픽입니다. 포트 미러링이나 TAP(Test Access Point)으로 복제한 사본은 암호화된 상태 그대로라 저장해도 내용을 확인할 수 없습니다. 따라서 암호화 통신은 SSL Proxy가 SSL/TLS를 복호화한 트래픽을 센서가 수집합니다.
하단 경로인 내부망 통신, 즉 동서(East-West) 트래픽은 볼륨이 크고 경로가 여러 곳으로 분산됩니다. 같은 패킷의 사본이 중복 생성되고 양방향 트래픽이 서로 다른 경로로 나뉘므로, 미러링 트래픽을 Network Packet Broker(NPB)에 먼저 집선(aggregation)한 뒤, 분산된 양방향 트래픽을 하나의 플로우로 재결합하는 플로우 스티칭(Flow Stitching)과 여러 지점을 경유하며 발생한 사본을 제거하는 중복 제거(De-duplication)를 수행합니다. 두 작업은 전체 트래픽이 집선되는 지점에서만 가능하므로 센서 분산보다 먼저 수행합니다.
정리된 트래픽은 센서 여러 대에 세션 단위로 분산하는 세션 단위 부하분산을 적용합니다. 센서는 패킷을 순서대로 재조합해 파일과 콘텐츠를 복원하므로, 같은 세션의 패킷이 서로 다른 센서로 나뉘면 어느 센서도 세션 전체를 확보하지 못해 부하가 균등하더라도 응용 계층(L7) 재조합은 실패합니다. 두 경로 모두 센서는 복제된 트래픽을 받기만 하는 Passive 방식이므로, 센서 장애는 운영 트래픽에 영향을 주지 않습니다.
설계를 적용한 뒤에는 실제 손실 여부를 검증합니다. 링크 업(Link Up) 상태인 모니터링 포트마다 대역폭(bps)과 패킷 처리율(pps)이 CEF(Common Event Format) 형식 Syslog로 주기적으로 전송되므로, 피크 구간의 캡처 속도를 평균값으로 추정하지 않고 관제 화면에서 직접 확인할 수 있습니다.
둘째 지점, 저장: 쓰기 속도와 보존 기간
둘째 지점인 저장에서는 쓰기 속도를 먼저 결정합니다. 수집 구간에서 손실을 없애도 저장 계층의 쓰기 속도가 캡처 속도에 미치지 못하면 패킷이 폐기되며, 이 손실은 디스크 용량을 추가해도 감소하지 않습니다. 따라서 스토리지 설계에서는 용량보다 쓰기 속도를 먼저 확인합니다.
캡처 속도와 쓰기 속도의 격차는 한 매체가 두 역할을 겸하지 않는 구성으로 해결합니다. [그림 1]의 오른쪽이 이 분리 구조입니다. 센서는 수집 직후의 고속 쓰기를 처리하도록 SSD 중심으로, 노드는 풀패킷 보존과 인덱싱을 담당하도록 대용량 디스크 중심으로 구성합니다. 센서가 고속 수집을, 노드가 장기 보존을 담당하는 계층형 구조입니다.
이어서 결정할 항목은 용량입니다. 총 용량은 일평균 캡처량에 보존 기간 요건을 곱해 산정하며, 같은 장비라도 트래픽 특성에 따라 실제 보존 가능 기간이 달라지므로 기준값은 해당 환경의 실측 트래픽에서 확보해야 합니다. 파티션별 사용률과 잔여 용량도 같은 방식으로 Syslog로 전송되므로, 산정값과 실제 사용량의 차이를 운영 중에 확인할 수 있습니다.
마지막 결정 항목은 보존 기간입니다. 보존 기간은 가용 용량이 아닌 조사 요건 기준으로 역산해 산정합니다. 침해를 인지한 시점보다 앞선 구간이 조사 대상이 되므로, 보존 기간이 짧으면 필요한 구간이 이미 덮어쓰인 상태가 됩니다. 저장된 패킷의 재조합과 Network Blackbox의 Rebuild(소급 재검사)는 모두 보존 기간 내 데이터에서만 결과를 반환합니다. 소급 재검사의 가능 범위를 저장 설계가 정합니다.
셋째 지점, 데이터 연동: 단절 없는 단일 파이프라인
셋째 지점인 데이터 연동은 보존된 데이터의 조사 활용 가능 여부를 결정합니다. 수집과 분석이 분리된 구조에서는 데이터를 별도 시스템으로 전송하는 과정에서 지연이 발생하고, 원본과 탐지 결과의 연결이 유지되지 않아 경보에서 원본으로 이어지는 조사가 다시 수동 작업이 됩니다.
이 단절을 없애는 구성이 로그와 풀패킷을 하나의 저장소에 두는 단일 파이프라인입니다. QUADX의 파이프라인 구성은 [그림 2]와 같습니다.
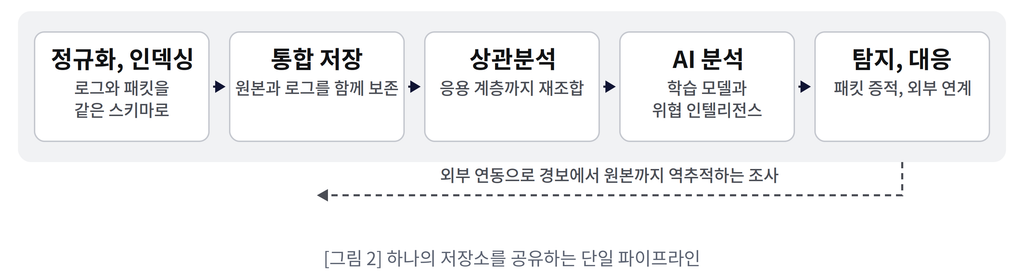
[그림 2]의 5단계는 정규화와 인덱싱, 통합 저장, 상관분석, AI 분석, 탐지와 대응입니다. 조사의 근거는 상관분석 단계가 생성합니다. 로그와 패킷을 응용 계층까지 재조합해 룰과 시나리오, 연관 관계로 위협 맥락을 분석합니다. 앞의 두 지점에서 확보한 풀패킷이 이 단계의 입력입니다.
외부 시스템에서 조회를 실행하면 연동 동작을 확인할 수 있습니다. [그림 2] 하단의 점선 경로처럼 외부 시스템이 연동 인터페이스를 통해 메타데이터를 검색하고, 동일 질의로 해당 세션의 원본 패킷까지 조회합니다.
이벤트 전송 범위는 탐지 이벤트 외 5종을 포함합니다. 탐지 이벤트와 세션, 메타데이터, 첨부파일, 시스템 상태, 감사 로그가 같은 CEF 형식으로 전송됩니다. 이 구조에서 수신 측 SIEM(Security Information and Event Management)이나 SOAR(Security Orchestration, Automation and Response)는 경보와 함께 그 경보를 원본으로 역추적할 키를 수신합니다. 대응 단계에서 PCAP(Packet Capture) 단위 증적을 그대로 확보하는 것도 이 연동 위에서 가능합니다.
배치 구조: AIO와 Expand의 판단 기준
앞의 세 지점(수집, 저장, 데이터 연동)을 모두 확보하는 구성은 트래픽 볼륨에 따라 달라집니다. 센서와 노드, 매니저 세 소프트웨어 모듈은 동일하며, 하드웨어 배치 방식에 따라 [표 3]의 두 구조로 나뉩니다.
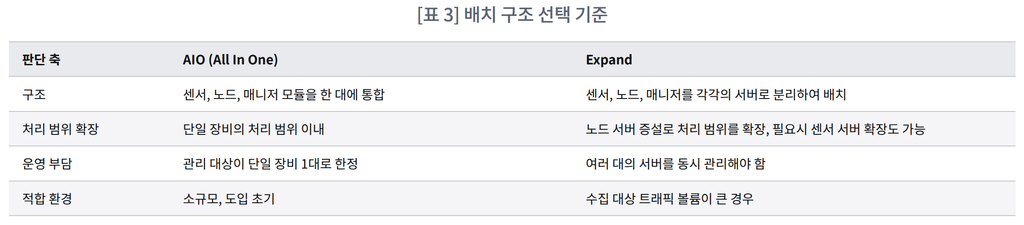
두 구조를 구분하는 기준은 수집 대상 트래픽 볼륨입니다. 단일 장비의 수용 범위를 초과하면 장비 사양을 높이지 않고 노드 서버를 증설해 대응하며, 캡처 대역폭이 센서 1대의 처리 범위를 넘는 구간에서는 센서 서버를 함께 증설합니다. 구성 선택의 입력값은 피크를 반영한 일평균 트래픽 볼륨과 조사 요건에서 역산한 보존 기간, 캡처 대상 구간, 운영 인력이며, 환경별 처리 범위는 도입 검토 단계에서 실측 트래픽을 기준으로 산정합니다.
처리량 설계와 자율보안운영 입력 데이터
앞의 세 지점과 배치 구조는 자율 판단의 입력을 확보하기 위한 설계 항목입니다. 공격 실행이 자동화될수록 분석가가 경보를 개별 확인하는 운영으로는 대응 속도를 맞추기 어렵고, 탐지에서 분석, 판단, 대응으로 이어지는 Closed-Loop 자동화, 즉 자율보안운영(Autonomous Security Operations)이 필요해집니다.
자율 판단은 근거 없이 확정되지 않습니다. 원본 트랜잭션/세션이 실제 통신 내용을 확정하고, 행위기준선이 이상 여부를 정상 대비 수치로 제공하며, 탐지설명성(XAI)이 판단 과정을 검증합니다. 다만 수집이나 저장 구간에서 손실된 패킷은 원본 트랜잭션/세션에도, 행위기준선 학습에도, 탐지설명성의 근거에도 남지 않고, 데이터 연동이 단절된 구조에서는 생성된 3계층이 경보와 연결되지 않아 조사에 활용할 수 없습니다. 앞의 두 지점은 3계층의 생성을, 셋째 지점은 그 활용을 제한합니다.
제품 구성도 이 세 지점을 기준으로 나뉩니다. Network Blackbox가 수집, 저장 구간에서 3계층을 생성하고, QUADxAI(로드맵)가 데이터 연동 구간에서 로그와 원본을 하나의 조사 흐름으로 연결합니다. 확보된 3계층이 AI의 분석과 판정에 필요한 근거가 됩니다. 자율보안운영의 경쟁력은 대응 속도보다 세 구간에서 잃지 않고 남긴 데이터의 양입니다.
자주 묻는 질문
대용량 환경에서 풀패킷 저장을 하면 패킷 손실은 피하기 어렵지 않나요?
손실 조건은 네트워크 장비 자원을 공유하는 수집 방식, 분산 설계가 적용되지 않은 구간, 캡처 속도에 미치지 못하는 쓰기 속도로 한정되며, 대응 방법은 각각 경로에 개입하지 않는 캡처 방식, 세션 단위 부하분산, 고속 쓰기와 장기 보존의 분리입니다.
메타데이터만 저장해도 위협 탐지에는 충분하지 않나요?
메타데이터만으로도 통신 패턴을 확인할 수 있어 실시간 이상 탐지에는 효과가 있습니다. 다만 플로우 요약(NetFlow, IPFIX 계열)은 통신 대상까지만 알려주고 전송 내용은 담지 않으므로, 사고 이후 원인 분석이나 소급 재검사에서는 조사 범위가 제한됩니다. 따라서 필요한 조사 깊이에 따라 풀패킷 저장을 함께 둘지 판단해야 합니다.